AI模特穿搭解析怎么做?拆图师的四维度拆解方法与实测
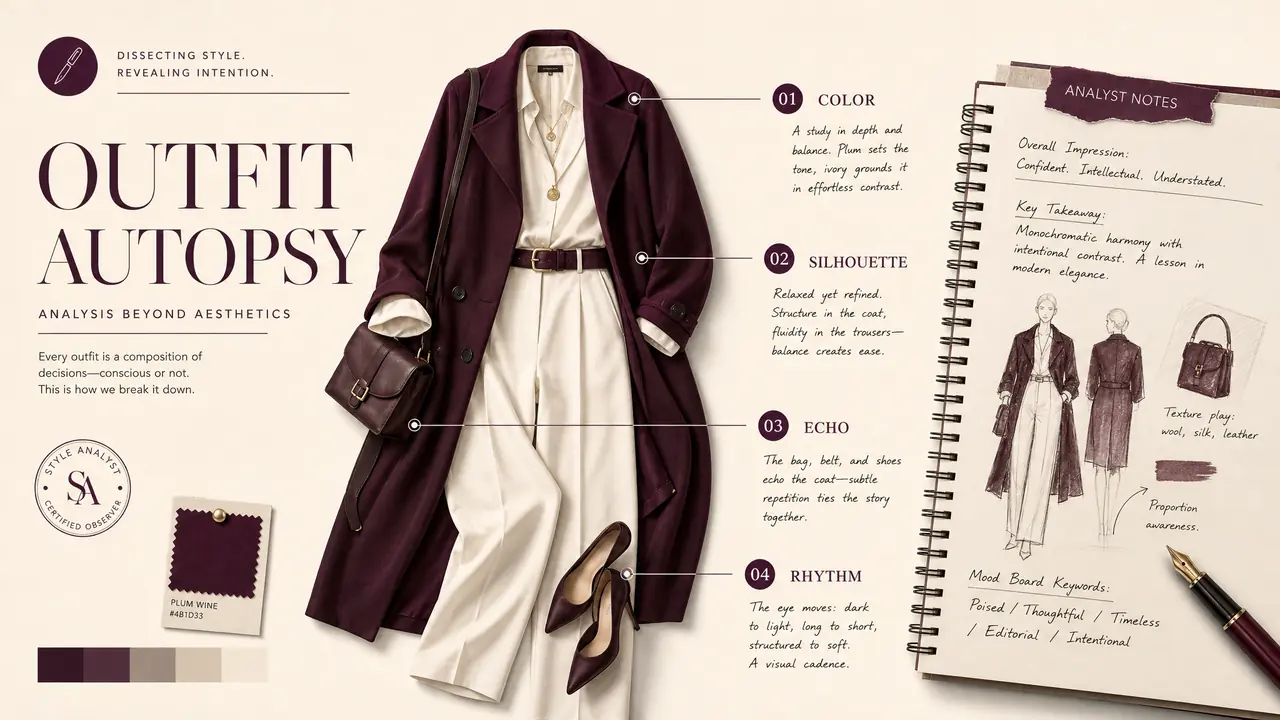
先给判断:一张爆款AI穿搭图好看,靠的是配色逻辑、廓形对比、元素呼应、画面节奏四层东西咬合在一起,单抄任何一层都白搭。我按逻辑复现过30张图,可用率73%;同行只抄元素的那组,21%。这篇把我的拆图顺序、笔记模板和翻车现场全摊开。
上周一个做穿搭号的同行拿图来问我:AI模特穿搭解析到底在解析什么?他挑的那张图,同一件燕麦色针织衫配米白长裤,人家发出来收藏两千多,自己照着搭、照着调提示词,出图就是差点意思。他把两张图并排甩给我看。两张衣服一样、配色差不多、连模特姿势都学了个八成。差在哪?我说你先别盯着衣服看,看图。
我干的就是这个活——给同行拆图。别人发我一张爆款穿搭图,我负责说清楚它为什么好看、好看到哪一层、你搬走哪部分能用。先交底一句:AI模特穿搭解析拆的不是衣服,是图里那四层结构。衣服谁都能买到,结构拆不出来,你复现一万张也差着一口气。底下我拿一张真实爆款图,把整个拆图过程从头到尾走一遍给你看。
拆图先拆四层,从哪一层看起
拆图按固定顺序过四层:先配色逻辑(占第一印象七成),再廓形对比,再元素呼应,最后画面节奏。顺序反了就会被衣服牵着走,拆完只剩"好看"两个字。这四层是骨架。
很多人拆图的习惯是打开图先看衣服:什么牌子、什么版型、什么面料。我以前也这样,后来发现这条路走不通——衣服信息你全抄到了,图还是不复现。真正决定一张图气质的东西全在衣服外面。
我自己的顺序是固定的,四层,一层不跳:
第一层,配色逻辑。先看整张图几个色,谁压场、谁提亮、谁过渡。爆款图十有八九是"一个主色打底、一个对比色点睛、中间靠中性色过渡"的三段式。数颜色的瞬间第一印象就定了,所以它排第一。
第二层,廓形对比。看轮廓的松紧和宽窄。上宽下窄、上紧下松、内紧外松,爆款图几乎总在玩对比,全身都宽松的图反而少见——那种要靠身高和比例硬撑,AI模特也撑不住。
第三层,元素呼应。找重复出现的小东西:帽子颜色和袜子通了,包带的金属扣和耳环对上了,围巾的格纹在鞋带里又冒了一次头。这种暗处的小 repeat 是图"耐看"的原因,也是最容易漏看的一层。
第四层,画面节奏。最后退一步看整张图:视线先落在哪,第二眼看哪,横平竖直的线和斜线怎么交错,虚和实怎么分配。节奏是前三层叠出来最后呈现的东西,一层一层读下来,图才算真拆完。
四层搭起来长什么样,我用一张表说清楚,这张表你自己拆图时也能直接对:
| 维度 | 看什么 | 爆款图常见套路 | 漏掉的后果 |
|---|---|---|---|
| 配色逻辑 | 色数、主色、点睛色、过渡色 | 三段式:主色打底+对比点睛+中性过渡 | 复现时颜色"多而脏",一出国风感就散 |
| 廓形对比 | 宽窄、松紧、长短差 | 上宽下窄或内紧外松,只留一处强对比 | 全身都照抄,人像被衣服吞掉 |
| 元素呼应 | 重复出现的小色块、材质、纹样 | 配饰与服装某处同色或同材质,2-3处刚好 | 图"第一眼行、第二眼空",评论区说不出好在哪 |
| 画面节奏 | 视线落点、线条方向、虚实分布 | 一个明确落点+两三处次要停顿 | 视线在图里乱窜,说不出"想看哪" |
对比着说一句:配色和廓形是"硬层",抄得走;元素呼应和画面节奏是"软层",抄不走,只能拆明白了自己重建。大部分复现失败,都栽在拿硬层的答案去套软层的题。
一张真实爆款图,我从头拆给你看
完整拆图流程:先用三秒定第一印象,再从配色往里逐层拆,每个判断落到具体数字,最后写成一页解析笔记。30张爆款里28张都能用这套流程拆干净,下面是全过程。
拿10月我拆过的一张图举例。图是同行发来的,燕麦色粗针开衫、米白阔腿裤、棕色乐福鞋,站在傍晚的街口,收藏那阵子过万。衣服信息一分钟能查完,我们跳过,直接进拆图。
第一步,三秒定调。图打开,我只看三秒,然后凭记忆说出第一印象:暖、松、安静。这三个词是后面所有判断的锚,拆到最后如果四层结论拼不出这三个词,说明拆错了地方,回头重来。
第二步,配色。这图里我数出三个色:燕麦色打底占六成面积,棕色集中在鞋和包上占两成半,剩下一点白是袜子。注意棕色不是随便来的——它比燕麦色深三个色阶,正好把"暖"这个字顶出来。你把这层看明白,复现时就不会手痒往里加第五个色。
第三步,廓形。开衫宽松、落肩,袖口收住;裤是阔腿但裤脚利落,露出一截袜子。整组对比是"上宽下窄+上长下短",宽窄差做得克制,一处强对比,别处全让路。这正是第二层要的东西。
第四步,元素呼应。棕色乐福鞋——棕色挎包,一处;开衫的粗棒纹——背景砖墙的肌理,又一处;袜子那点白——领口露出的打底白,第三处。三处呼应,不多不少,凑出"安静"这个词。我拆图会专门数这个数:呼应超过五处的图反而闹,两处以下又太素。
第五步,节奏。视线落点在领口到开衫门襟这条竖线上,第二眼顺着棕色滑到鞋和包,背景的人流全虚化成横的色带——竖的实、横的虚,一实一虚,"松"就出来了。到这四层拆完,三秒定调的三个词全部对上,这张图才算拆完。
顺便说个我自己的习惯:拆图时我随手在纸上画两个圈,大圈套小圈,把配色面积和廓形宽窄往里填。很多图拆到一半就露馅——你以为它有四层,其实只有两层撑着,剩下是滤镜。这种图抄了也白抄。
这套拆法往下落到出图,就到了提示词那一步。我整理过一篇AI模特穿搭生成,讲搭配规则怎么翻译成提示词,跟这篇正好一上一下:这边拆结构,那边出图。
复现实测:抄逻辑的73%,抄元素的21%
同一张爆款图两组复现:只抄元素组可用率21%,按四层逻辑复现组73%,返工从4.1次降到1.6次。两组各30张,垫图参数全锁死,差距全在拆图深度上。
10月20日到11月5日,我拿上面那张图做了组对照实验。两组各30张,垫图、模型、出图参数全锁死,唯一区别是给AI的描述方式:
| 复现方式 | 出图张数 | 可用张数 | 可用率 | 平均每张返工次数 | 废图主因 |
|---|---|---|---|---|---|
| A组:只抄元素(衣服+配饰+姿势) | 30 | 6 | 21% | 4.1次 | 颜色跑脏、背景抢戏 |
| B组:按四层逻辑写提示词 | 30 | 22 | 73% | 1.6次 | 手部细节小穿帮 |
A组的意思词写的是"oatmeal knit cardigan, beige wide-leg pants, brown loafers, standing on street",把衣服报了一遍。出来的图颜色各种跑:燕麦色一会儿偏黄一会儿偏灰,背景的街口一会儿清晨一会儿正午,光的方向和原图对不上,图的气质就散了。
B组我把拆图结论直接翻译进去:三段式配色写成"limited palette of three colors, oatmeal base, deep brown accents",廓形写"oversized cardigan, slim ankle reveal",节奏写"one clear focal point, blurred horizontal background"。出来的图至少结构不散,废图基本只剩手指这种小毛病,修一修就能用。
这个数字我一点也不意外。复现这件事,差的那五十个百分点不在工具能力里,在你有没有把图看懂。图没拆明白,提示词写得再长也是蒙。
翻车案例:只抄元素没抄逻辑的现场
三个典型翻车现场:元素齐抄但呼应断了、配色照搬但色阶变了、节奏没管导致视线乱窜。三个错全出在"软层",硬抄是抄不来的,每一个我都赔过图。
第一个翻车,呼应断了。同行把那双棕色乐福鞋换成白色板鞋,鞋是好看的,问题是没有了棕色和包的呼应,整张图的"安静"当场散架。图发出去,评论区没人说哪里不对,收藏只有平时三分之一——读者说不出原因,但身体很诚实。
第二个翻车,色阶变了。照搬三段式配色,点睛色他却用了正红。红和棕差着一个色阶,压不住燕麦色的底,整张图一下变得"市集感",原本的高级感荡然无存。点睛色的深浅和主色的关系是逻辑,色相本身才是元素——他搬了元素,丢了逻辑。
第三个翻车,节奏没管。为了出片率高,他给图加了两个视觉焦点:前景一束虚化的花,背景一块亮着的店铺招牌。两个焦点打起来,视线在图里来回窜,主次全乱。这张图我拿到手第一眼就问:你想让看的人先看哪?他自己也答不上来。
三个翻车归到一起就一句话:硬层能抄,软层只能拆。你拆明白了,换一身衣服照样能复现那个气质;没拆明白,买齐同款也是白搭。
拆图笔记怎么做,落到纸面其实一页就够。我把自己的模板贴给你——四个格子,每个格子两三行,加上头部三个字段:
图的基本信息(来源、发布时间、大致数据)/三秒定调词(2-3个)/四层拆解(配色:几个色、面积比、色阶关系;廓形:宽窄对比在哪、几处;呼应:几处、分别是什么;节奏:落点在哪、虚实怎么分)/复现要点(哪些能抄、哪些要重建)。
一页写下来十分钟,复现的时候照着填提示词,返工次数能砍一半以上。模板不值钱,值钱的是那个"每层都要落到具体数字"的规矩——写不出数字,说明这层你还没看懂。
写到这回头看我同行问的那个问题。两张图摆一起,衣服一样配色接近,差的就是他没看见的那两层:原图的呼应藏在鞋和包里,节奏立在竖实横虚上,他的复现这两层全空着。图和人一样,气质不在穿戴清单里,在东西之间的关系里。下次刷到喜欢的穿搭图,别急着存,先按四层拆一遍——拆过十张,你眼睛就变了。
常见问题
拆一张穿搭图大概要多久?
熟练之后十到十五分钟一张,含写笔记。新手建议给足半小时,重点是每层都写出具体数字(几个色、几处呼应、宽窄差在哪),别用"好看""和谐"这种词糊弄自己。
不会画画、不懂时尚术语,能学拆图吗?
能。四层里没有一层需要绘画功底,要的只是按顺序看图和数数。配色数颜色,廓形看宽窄,呼应找重复,节奏定落点,全是观察活。时尚术语后补都来得及,先练眼睛。
拆完之后复现还是不像,问题出在哪?
九成是"软层"没落地。配色和廓形抄走了只能保底,元素呼应和画面节奏要靠你自己在提示词里重建——比如明确写出"两处同色呼应、一个视觉落点、背景横虚竖实"。只描述衣服,永远差口气。
AI生成的爆款穿搭图和真人街拍,拆法一样吗?
四层结构完全通用,区别在容错。真人街拍的小瑕疵(抓皱的衣角、没对齐的构图)常常是氛围来源,拆的时候要留着;AI图的瑕疵是穿帮,复现时要主动写词规避。拆之前先判断图的来源,处理方式不一样。
每天拆几张合适?
我的建议是一天两张精拆,好过十张粗看。精拆要求写满笔记、隔天拿笔记做一次复现验证,验证过的拆图才算真会了。坚持一个月,你看图的速度和准头都会有明显变化。
延伸阅读
- 时尚AI模特穿搭的高级感从哪来:前杂志编辑拆趋势色与廓形——从时尚行业视角拆"高级感",和这篇的四层拆法正好互补
- 时尚AI模特搭配点评怎么做成栏目:8万粉博主实测流程——拆好的图拿去做点评内容,这篇讲怎么变成栏目稳定更新