ai绘画虚拟形象怎么做:从人设卡到三视图,捏出你的虚拟分身
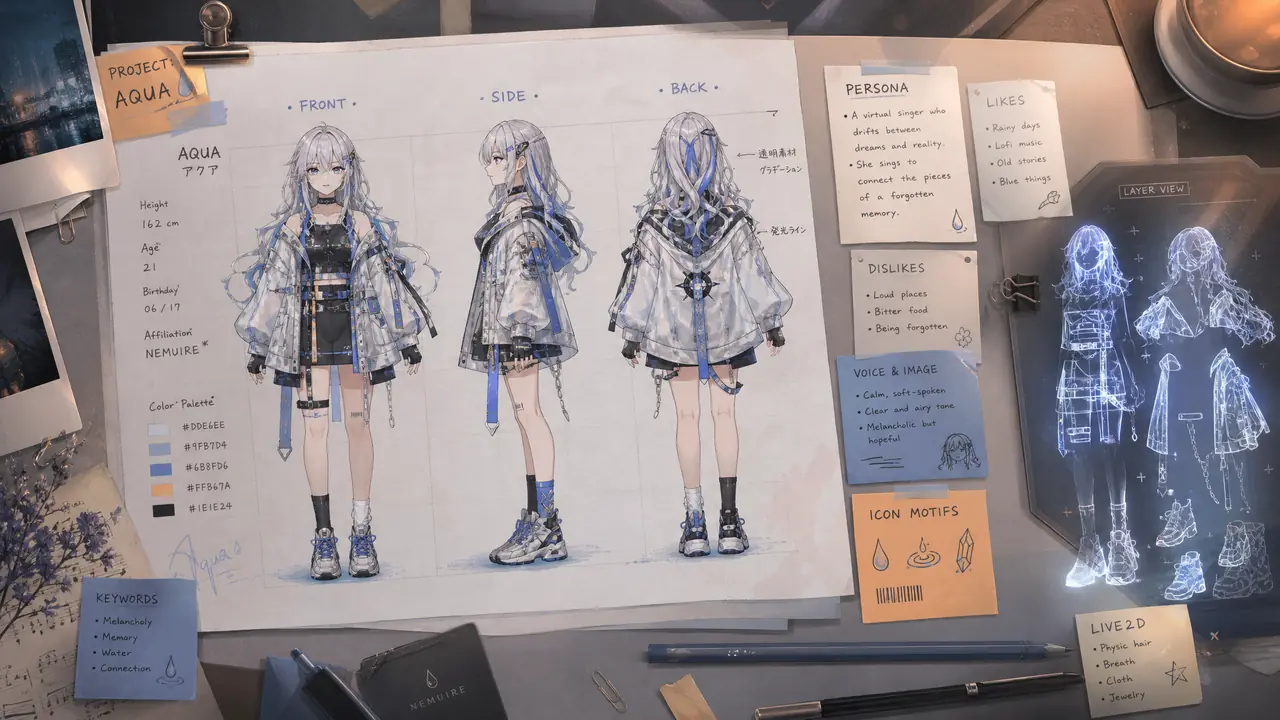
开门见山:虚拟形象成败的分水岭在出图之前。人设卡写不清楚,抽再多卡也只是一堆互不认识的陌生人。先花两小时把身份、记忆点、性格写死,再按文生图找方向、重绘定五官、LoRA保一致性的顺序走,一个周末足够定稿。
AI绘画虚拟形象这件事,我劝你把七成功夫花在点生成按钮之前。真不是玄学。我2026年8月底给自己的虚拟分身立项,9月中旬才定稿,前后废掉两百多张图,最大的收获倒不是图,是想明白了一件事:形象跑偏的锅,九成在前期人设含糊。
起因很实际。想做一档长期更新的短视频账号,真人出镜压力太大,就打算捏一个能一直用下去的虚拟分身,往后要是开播,同一套形象直接顶上。目标定了,事情就清晰了——这不是画一张好看的图,是造一个「人」。图会过期,人会沉淀。
先写人设卡,三行字比三十张图管用
人设卡只需三行:身份内核一句、视觉记忆点两个、性格底色三个词。这三行写不出来,说明形象还没想清楚,先别打开绘画软件。
我那张卡是这么写的。身份内核:「下班后偷偷搞创作的上班族」。视觉记忆点:银灰挑染短发,加左眼角一颗泪痣。性格底色:嘴硬、心软、反应慢半拍。就这么多,写完大概花了两小时,中途删掉四个自以为很妙的设定。删的时候肉疼,后来发现删得对。
记忆点为什么只要两个?因为AI记不住五个。提示词里塞五个外貌特征,出图必定丢两个,丢哪个还随机,等于你亲手往里灌噪音。人设卡就像盖楼前的户型图,户型图都画不明白,施工队只能瞎砌。配色同理,主色定一种、辅色两种封顶,我定的是雾蓝加暖白,再点一点橘,结果那点橘后来成了评论区喊我「橘子姐」的由头,属于意外之喜。
性格底色这行看着虚,用处最实在。反应慢半拍,直接决定表情差分里要有一张「迟了两秒才笑」的懵脸;嘴硬心软,决定文案的口吻。形象是壳,性格是让壳动起来的线路,这条线不接,图再美也只是壁纸。
三条出图路线,我用数字替你排过序
找灵感用纯文生图,定稿靠参考图重绘,量产交给LoRA。三条路线按阶段切换,别指望一条路走到黑。
2026年9月那两周,我把三条路线各跑了一轮,工具是Midjourney做文生图、即梦做参考图重绘、租了张云4090跑SDXL训练。先看账单式的对比,再说细节。
| 路线 | 单张耗时 | 形象一致性 | 花费 | 适合阶段 |
|---|---|---|---|---|
| 纯文生图 | 约15秒 | 低,每张脸都在变 | 订阅费均摊,可忽略 | 定风格、找方向 |
| 参考图重绘 | 约20秒 | 中,幅度调对能稳住五官 | 同上 | 有满意底图后微调 |
| 训练专属LoRA | 一次约35分钟 | 高,换姿势换装脸不漂 | 云GPU约4元 | 人设定稿后量产 |
文生图阶段别心疼抽卡量。我第一晚抽了37张,能用的2张,这个命中率是正常的,不用怀疑自己。重绘阶段有个关键旋钮:重绘幅度。我反复试下来,0.45到0.55之间五官最稳;低于0.4,改动太小,想换的发型换不掉;一旦高过0.6,那颗泪痣说没就没,挑染也开始乱跑。幅度就当火候,宁可小火慢炖。
翻车也翻在这。有一晚我往提示词里堆氛围词,逆光、赛博霓虹、粒子特效,越堆越起劲,结果脸越来越偏,八张里挑不出一张像人设卡的。删光特效词重跑,八张里六张能看。不夸张地说,人设图阶段,特效词就是菜里的沙子。LoRA那步反而顺:挑了28张成图当训练集,1024分辨率,跑1600步,35分钟出模型,云GPU账单4块钱。低于20张图的训练集我也试过,脸会漂,别省那几张。
定稿别急着庆祝,差分和拆层才是大头
定稿后先做9张表情差分加一张三视图,再谈拆层。直播要用的模型图层拆不干净,形象就动不起来。
表情差分我用的办法很笨但稳:重绘幅度压到0.3,表情词一次只换一个。第一版我贪心,表情和角度一起换,出来的图表情不对、角度也歪,全废。改成一次一词之后,微笑、愣住、大笑、委屈、黑线、星星眼这套九宫格,一小时出齐。三视图就是正面、侧面、背面各一张,它是后面所有工序的施工图,值得多抽几轮挑最准的。
拆层是我摔得最疼的一跤。以为把定稿图丢给做Live2D的师傅就行,结果图带背景、刘海跟肩膀粘在一起,师傅直接退回,我自己补抠了两晚上,抠到看见头发丝就烦。现在我的原则写死在流程里:定稿一律出透明底、高分辨率版本,头发按前、中、后三层分,眉毛、眼睛、嘴各自独立。话说回来,不是人人都要走到拆层这步——只发图文内容的话,差分就够用了,别为用不上的工序熬夜。
回到开头那句:功夫在出图之前。人设卡两小时,文生图找方向一晚,重绘定稿一周,LoRA一个下午,这就是我全部的时间账,两张表加起来两百张废图里练出来的。形象终究是壳,观众留下来看的是那个「人」说的话、做的事。捏脸适可而止,把省下的时间花在内容上,你的虚拟分身才活得久。
常见问题
虚拟形象会不会和真人明星或者别人的角色撞脸?
靠记忆点组合来避。挑染加泪痣这种「两三个私有特征」的搭配,撞脸概率很低。定稿前拿成图反搜一遍识图,心里就有数了。另外守一条底线:做的是原创虚构人设,不拿AI图冒充任何真人。
做虚拟主播形象,必须自己会拆层和Live2D吗?
不必须。只发图文,差分就够;想动起来可以外包拆层和模型制作,2026年9月我在闲鱼问过一圈,简单款几百块,带物理效果的复杂款能到两千上下。自己只需交出干净的三视图和透明底源图。
训练LoRA一定要本地显卡吗?配置不够怎么办?
不用。云GPU按小时租,我那次35分钟花了4元左右,4090级别的卡。训练集28张起步,别低于20张,图少脸容易漂。全程不需要本地机器多好,一台普通笔记本加远程桌面就够。
形象做好发出去,怎么防被人盗用?
三件事:公开图统一打半透明角标水印;三视图和拆层源图这类「施工图」不外发全尺寸;发现盗号盗图,先走平台侵权投诉,一般当天就有处理。别一上来就发律师函,成本不划算。