开车ai绘画实测:后视镜构图、公路光影和车内视角
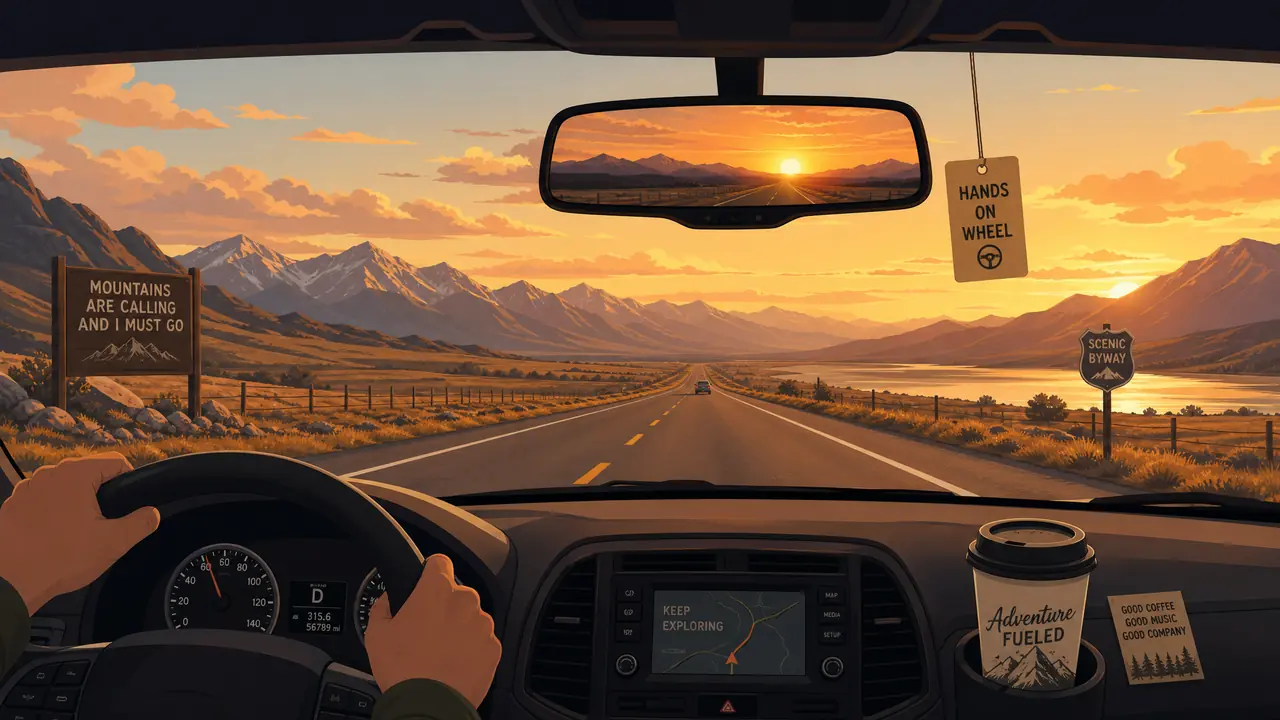
直接给结果:三组构图里车内视角最稳,后视镜构图最出片,黄昏公路光轨最难伺候。30张实测挑出8张能用的,改词记录一条不落,全在下面。
上周跑了趟三百公里的短途自驾,我坐副驾,抱着平板折腾了一路驾驶场景的出图,回家整理出这组实测。先插一句正经的:方向盘后面那位请把手机收好,出图这件事留到服务区或者到家再做——图什么时候都能出,安全可没有重来的机会。至于副驾上的我,除了出图还负责递水、报导航和找服务区,一人干三份活,不亏。三组构图测试统一用一个写实向底模,只改提示词里的构图和光线部分,方便对比。
车内视角:方向盘加前挡风,新手也能一次出图
车内视角成功率最高,唯一的高危点是握方向盘的手,把动作改成「手背朝镜头」能避开大部分翻车。
我先测的是最保守的车内主视角:「驾驶位视角,双手搭在方向盘顶端,前挡风外是山间公路,晨雾」。这个组合算是驾驶题材里的「白米饭」,不惊艳,但饿不着。前10张的构图几乎不用改,AI对车内空间的理解相当扎实——仪表盘、后视镜、挡风玻璃的层次都摆得明明白白。翻车集中在手上:10张里6张握方向盘的手指数量不对,四根的、六根的都有,像外星人来借的车。改词只改一处,「双手搭在方向盘顶端,手背朝向镜头」,把手指藏起来,后8张全过。还有个有趣现象:不写司机的时候,十张里七张驾驶座是空的,估计训练照片里空车展示图占了太多,模型默认车里没人。想要有人,就把「驾驶员」单独写进词里,别指望它自觉。另外提一句,车内视角配「晨雾」「傍晚」这类光线词,画面的故事感会强一个档次,但光线词一次只给一个,给两个模型就打架,出图会往怪里走。
后视镜构图:一张图装下两个故事
后视镜构图的关键是交代镜里镜外两层景深,镜中写路,镜外写车身虚化,一层都不能省。
这是整轮实测里最出片的一组,也是唯一一组我在服务区就忍不住发出去的。提示词我磨了三版:第一版「汽车后视镜特写」,太平,像车辆说明书的配图;第二版加了「镜中是暮色下的公路」,开始有味道;第三版定型为「外后视镜特写,镜中是暮色公路和远山,镜外车身虚化,镜面有一道细划痕」,直接封神——划痕这个词是我临时起意加的,效果意外地好,真实感一下就上来了,那张图后来成了我的手机壁纸。对了,「远山」也别省,它负责把镜中那条路的尽头托住,画面才不会闷。后视镜构图妙在一张图两个世界:镜子里是走过的路,镜子外是正在走的路。模型对这种嵌套结构的理解比想象中好,这类「画中画」的构图都值得多喂几个词。
黄昏公路的光轨,为什么总差一口气?
AI画车灯光轨容易画成悬浮的发光线条,补上「贴着路面、连续不断、长时间曝光感」三个限定词才有公路片的味。
黄昏加光轨,听着浪漫,实测最难。头几版的问题很明显:车尾灯的红线是飘在半空的,跟路面没什么关系,像谁在公路上空吊了根发光的面条。更早的两版干脆把对向车灯也拉成线,双向四条红线并排飘着,密集恐惧症都要犯了。改了三轮词才压住:加「贴着路面延伸」「连续不断」「长时间曝光的摄影感」,光轨总算落了地,红线顺着车道线一路铺向落日。我最后选用的参数是896x1152竖幅,步数28,CFG6.5,出片率大概三成,比另外两组低了一半不止。跟车内视角比,这组废片多,但成了就是狠片,值回票价。哦对,还有一版把太阳画成了两个,一上一下,我至今想不通模型当时在想什么。
三百公里的路,去程测了车内视角,回程测了后视镜和光轨,到家该做的事一件没耽误。八张能用的图,废片二十多张,账面成绩不算漂亮,但每一张废片都换回一条能复用的改词经验,这笔账怎么算都不亏。驾驶场景之所以好看,是因为它天然带着「在路上」的叙事感——模型给骨架,你给方向。下次长途,副驾的你不妨也带上平板试一轮;至于开车的,眼睛盯着路,图,我们回家再出。
常见问题
为什么AI画的司机经常没有手,或者驾驶座是空的?
训练数据里有大量无人展示的车辆宣传图,模型对「空驾驶座」的先验很强;手又是绘画模型的经典弱点。要人就把「驾驶员」明确写进提示词,要稳就把手的姿态改成手背朝镜头,两个坑各有各的绕法。
想要副驾视角的图,关键词该怎么排?
把「副驾驶位视角」放在最前面,再补「侧脸对着车窗,窗外光影扫过面部」这类描述。副驾视角天然带情绪,适合配人物,出图重点在车窗的光影流动,比驾驶位视角更出氛围。
这类驾驶场景的图发到社交平台,要注意什么?
记得勾选AI生成标识,别在配文里暗示是自己实拍的旅途照片。驾驶场景太容易让人当成实拍,尤其后视镜和光轨这类写实向构图,标清楚反而显得坦荡,也省去评论区一遍遍解释。