ai很难绘画的东西有哪些?手部、镜像、文字招牌与姿势的实测对策
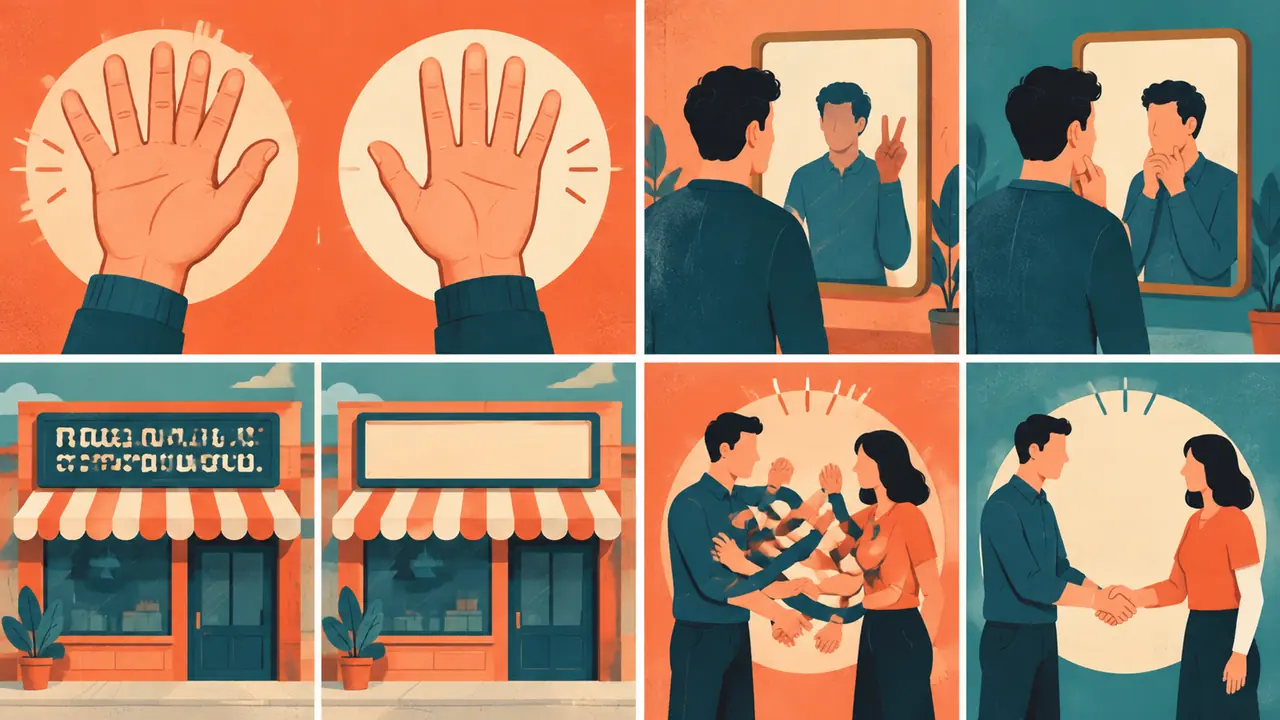
直白亮观点:ai很难绘画的东西就四类——手指、镜像反射、招牌文字、双人互动姿势,毛病各有根源,光换新模型救不了。这四样翻车占了废片的大头,逐项对症下药即可。先照清单对号入座,再按对策改提示词或换工具,废片率能压下去一大半。
ai很难绘画不是玄学,翻车点其实相当固定:手指数量、镜面倒影、招牌汉字、双人拥抱,这四样吃掉了日常废片的绝大多数。结论先放在这:每一类都有对策,而且多数对策跟换不换新模型关系不大。模型升级能少错几张,救不了根本。
我上周专门做了一轮实测,四个难点各写一条固定提示词,每条跑十张,逐张记录可用数,再按各自的改法重跑一轮对比。数字不好看,但改完之后每项都翻倍以上。这份清单就是照实测结果写的:谁先崩、为什么崩、怎么救,一项一项说清楚。
手部为什么总崩:数据欠的债,提示词还不清
手部是清单里翻车率最高的一项,训练集里手常被遮挡,模型没学透五指数量。光改提示词不到三成能用,参考图加局部重绘能到八成。
实测细节先摆出来。提示词写「单手举咖啡杯的手部特写」,跑十张:四张六指,三张指节粘连,能用三张。同一个人物换到全身景别,手只占画面十几个像素,可用率立刻回到九成。崩不崩,跟手在画面里的占比直接挂钩,占比越大越危险。
对策分三层。构图上让手拿东西、扶东西,被道具遮住一半反而自然;提示词写「五指张开、掌心朝镜头」这类训练照片里常见的明确姿态,比写「自然的手」管用得多;真崩了就局部重绘,蒙住手,重绘幅度压到 0.4 左右,八成能救回来。说实话,第三层是我用得最多的,前两层是为了少进第三层。
一个翻车案例。我画过一张弹吉他的手,左手按弦、右手拨片,局部重绘三次,手型是直了,琴弦却穿过了手指。这种跟道具互动的手最难救,宁可把构图改成手搭在琴身上不按弦,也别硬磕。
镜像反射错在哪:模型不懂光路,只懂像素规律
镜像反射崩在物理一致性:模型不懂光路,倒影动作、左右和光源常错。十张湖面倒影仅一张正确,显式描述光路后能到六成。
十张湖边站人倒影,倒影里的人和岸上动作完全一致的只有一张,剩下的要么左右手反了,要么水里多出第三个人。玻璃橱窗更夸张,反射里连店内陈设的透视都是乱的,杯子在窗右下角,倒影却飘到了左上角。
对策有三条。第一,把反射逻辑直接写进提示词,比如「倒影与人物动作镜像对称,水面平静」,等于替模型立规矩。第二,降低反射里的信息量,人物选背影或静止站姿,别让镜子里也做复杂动作,镜子画面里人越少越稳。第三,后期把水面压暗,只留轮廓光,观感反而更真实。
个人觉得被高估的是「换大模型能解决反射」这个说法。我换了两代模型重跑同一批图,错误率只降了一成上下,该错还是错。这是物理理解层面的缺口,不是算力问题。
文字招牌别死磕:留白加后期,比提示词可靠
招牌文字是中文重灾区:通用模型几乎写不对汉字,英文常见词约六成正确。要出带字的图,换海报工具或后期贴字。
实测里最扎心的一项。「老王面馆」四个字的招牌,跑十张,零张全对,最接近的一张把「馆」写成了左右结构颠倒的怪字。英文「NOODLE」十张对六张,错的四张全是字母顺序被打乱,一看就是模型在拼凑形状,压根不认识词。
所以路子要换:构图时让招牌留白或虚化,后期用贴字工具把真实文案压上去,十张里九张能用,文案还能随时改。要直接出带字的成图,海报类专用工具对汉字的渲染好得多。汉字具体怎么绕,招牌包装上的汉字总被画成生造字,三条路子绕过去那篇拆得更细,这里不重复。
一个取舍提醒:招牌上出现真实品牌名或字体时,个人欣赏自用没问题,商用授权另算,字体版权和商标都得单独确认。
复杂互动姿势:先拆开,再合上
双人互动姿势要拆解着做:一步到位的拥抱姿势十张只有两张能看,先用骨架图分别定姿态再合成,通过率能拉到七成。
「两个老朋友拥抱」一步到位,十张里两张能看,问题集中在胳膊打结和两张脸融在一起。把提示词改成两句分开写——「左边的人张开双臂,右边的人侧身相迎」,能看的多两张,但脸部偶尔还是会糊。方向对了,力度不够。
真正稳的是骨架控制:先用骨架图分别摆好两人的姿态,接触点只留一个,握手或搀扶都行,通过率能到七成。接触点越多越崩,拥抱这种双点接触基本是难度天花板,能避就避,实在要画就做好局部重绘两三轮的心理准备。
四项难点的实测对比如下,前后两列都是同一提示词跑十张的结果,区别只在于有没有用对策。
| 难点 | 典型翻车 | 主要对策 | 可用张数变化 |
|---|---|---|---|
| 手部特写 | 六指、指节粘连 | 参考图加局部重绘 | 3 张到 8 张 |
| 镜像反射 | 倒影动作错、多出人 | 显式写光路加减细节 | 1 张到 6 张 |
| 文字招牌 | 汉字生造、字母乱序 | 留白后期贴字 | 0 张到 9 张 |
| 双人姿势 | 胳膊打结、脸融合 | 骨架控制单接触点 | 2 张到 7 张 |
数字会随模型版本浮动,排序基本不变:手最难救,文字最好绕。照抄改法就能用,不用纠结参数完全一致。
清单收拢起来就四个词:手、镜子、字、姿势。共同点也摆在那了——全都是模型对「物理世界怎么运作」理解不到位的地方,跟风格、审美的关系反而小。下次出图先扫这四处:手指先数,倒影再看,招牌最后抠,姿势嫌麻烦就上骨架。按这个顺序排查,省下的重跑时间够你多出好几组图。
常见问题
ai绘画手指画错,换新模型能彻底解决吗?
新模型确实少错,特写手势照样崩。参考图加局部重绘仍是主力手段,模型升级只当加分项,别指望一步到位。
为什么ai画的镜子里的人和真人对不上?
模型训练时看的是照片像素,镜面在照片里常被裁切或反光过度,它学到的是「这里大概有个倒影」,不是完整光路,所以动作和左右经常对不上。
AI生成的中文招牌图可以直接拿去商用吗?
不建议直接用。生成的字体可能撞上商用授权,招牌样式也可能近似真实商标,商用前把字体版权和商标查一遍,贴字环节选有授权的字体最稳妥。
两个人握手的图怎么让手指不粘连?
握手点用骨架图锁定,崩了就单独局部重绘这个部位。提示词写「双手相握、五指分明」比写「十指相扣」稳,后者的手部细节太密,更容易糊成一团。