ai模特测评:同5款服装各跑50张,两款工具的成绩单
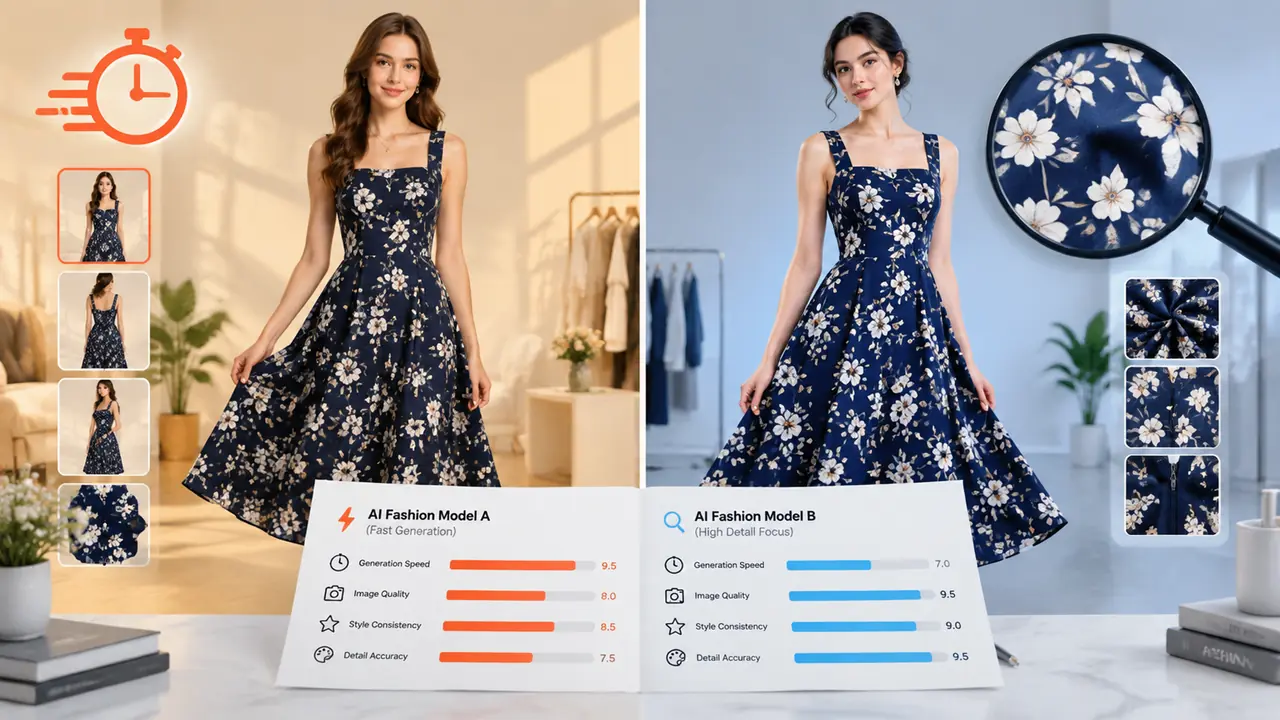
我的判断是:ai模特测评别看宣传页,看废图率。绘蛙和美图设计室各跑50张之后,我的结论是前者快且便宜适合铺量,后者细节稳适合首图,两款我现在都留着,各干各的活。
ai模特测评这个东西,网上大多数是截几张官方示例图就下结论,说服力约等于零。这次我下了点笨功夫:选店里5款常规服装,在绘蛙和美图设计室各跑50张,全程同参数同姿势库,数字一张张数出来。
先交代测试口径:连衣裙、衬衫、卫衣、牛仔裤、羽绒服各10张,手部五指完整且握姿合理才算过,服装图案清晰可辨才算还原。全在线跑,不掺本地显卡的变量。测完我对两家的看法变了不少。
测评怎么做的:5款服装、各50张、只看四个指标
连衣裙、衬衫、卫衣、牛仔裤、羽绒服各10张,统计服装还原度、手部成功率、单张耗时和单张成本,五个品类覆盖了薄厚纯花四种工况,评分口径全部摊开。选这五款不是随便挑的:碎花连衣裙专治图案糊,白衬衫专治版型飘,深色卫衣专治阴影脏,牛仔裤专治走线歪,羽绒服专治绗缝乱。一款工具能扛住这五关,日常店铺的活儿基本都能接。
| 指标(各50张) | 绘蛙 | 美图设计室 | 我的备注 |
|---|---|---|---|
| 服装图案清晰 | 41张 | 46张 | 碎花款差距最明显 |
| 手部合格 | 35张 | 39张 | 双方都怕双手交叉 |
| 单张耗时 | 约12秒 | 约26秒 | 高峰期双方都排队 |
| 单张可用成本 | 约0.2元 | 约0.45元 | 含废图摊销 |
两个数字值得单独说。手部那关,两家在"双手插兜"这个姿势上集体翻车,50张里合格率不到三成,我后来把这个姿势从姿势库里删了,省心。耗时那关,26秒对12秒看着差距不大,铺量的时候乘上三百张,就是一小时和两小时的差别。
翻车案例:羽绒服绗缝和衬衫扣子
羽绒服的绗缝线被AI画乱、衬衫七颗扣子变五颗,是这轮测评最常见的两类翻车,前者在提示词里强调绗缝走向能救回一半,后者只能靠局部重绘补。羽绒服是全场最惨的品类,100张里31张绗缝走向乱七八糟,还有的干脆把菱格画成了波浪。我在提示词里加了"绗缝线均匀平行"之后,翻车降到14张,能救一半,剩下一半是救不动的。
衬衫扣子这个更有意思,AI对扣子数量完全没有数,七颗扣的门襟它能给你数出五颗、六颗甚至九颗。我现在的流程里多了一道"数扣子",出图先数扣,不对就局部重绘扣门襟区域,幅度0.3,两三次内能修对。牛仔裤的裤缝走线歪也常见,好在多出几张总能抽到直的,不算大问题。
这些翻车跟工具关系不大,换哪款都差不多,根子在AI对"可数的小物件"没概念。所以别指望换工具解决,指望流程:出图、挑图、数扣、局部修,四步走完再上架。
这轮测评之后,我怎么分配两款工具的活儿
铺量的详情页内页图全给绘蛙,主推款首图和需要放大看的细节图给美图设计室,一条裙子混用两家,单款图片成本压到实拍的一成以内。账我算过:外模实拍一套三百起步,还要约档期等返片;AI这边我月均六十张,两家基础档加起来月开销五十块上下,量产一天下午就能跑完。这不是说AI哪儿都赢,细节放大看,实拍还是赢,所以首图这种一寸之地一寸金的位置,我现在反而倾向实拍加AI精修的组合。
声明一下利益相关:两家都充的最基础会员,谁也没给我钱,上面的数字仅代表我这个月的版本。模型更新快,下个月重测说不定就变了,这批数据当快照看。
日常排班也固定下来了:周一用绘蛙批量跑当季款,挑出来能用的进"待修"文件夹,周三集中做局部重绘和数扣子,周五统一上传。这么排下来,每周花在AI出图上的时间不超过五小时,搁去年这个量得占掉我整整两天。
想扩候选名单的话,我把五款工具的完整对比写在ai生成模特软件横评那篇里,连免费款一起评了。
这轮测评做完,最大的收获不是排名,是把预期对齐了:AI模特图现在的真实水平是"八成可用、两成要修",任何宣传九十几分的话都别信。按这个预期排流程、留返修工时,AI模特才能真正替你省下拍摄预算,而不是变成新的焦虑源。
常见问题
AI模特图和实拍差很多吗?买家会投诉吗?
基础款差距很小,复杂剪裁和特殊面料的还原还是实拍稳。我上线几个月没人因为"图不符"投诉过,返修率反而比实拍的色差问题还低一点。
测评里为什么不测本地部署的方案?
本地跑要折腾显卡和参数,跟在线款不是同一类用户,混在一起比不公平。我后面单独测一轮SDXL加ControlNet的本地方案,达标了再放出来比。
免费额度够测出一款工具的真实水平吗?
够用。每家拿十几张额度,专挑最难出图的款去试,翻车率一下就看出来了。免费额度省着点花在难款上,比平均撒在好出图的款上有用得多。
测出来的数据换个品类还适用吗?
趋势适用,具体数字会飘。童装、大码、运动服的翻车点跟女装不一样,建议照我的口径自己跑一轮小的,几十张就能摸清你那个品类的脾气。另外提一句,AI模特的脸是生成的,正常展示没问题,请勿用于冒充他人身份。