ai模特摆姿指导:前影楼摄影师的姿势词写法与穿帮修法
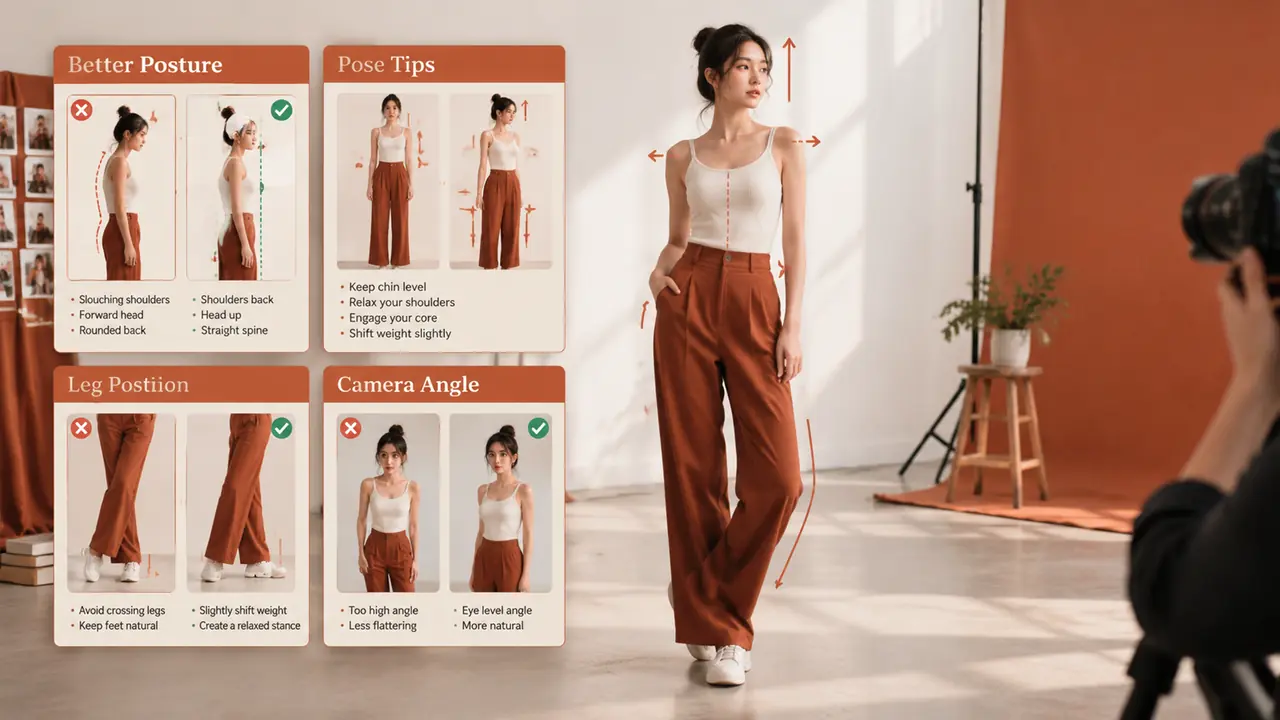
AI模特图能不能用,八成卡在摆姿上:姿势词按"动词+重心+手部位置"三件套写,出片率能从31%提到68%。先把现有提示词里的姿势描述翻出来,对着三件套检查缺哪项,再动手跑图。
ai模特摆姿这件事,我干了十年影楼摄影,转做AI出图一年,攒下87条姿势模板之后才敢说一句实在话:模型决定了脸和衣服的上限,摆姿决定了你一张图要跑几次的下限。同样一件风衣,姿势词写"站着",我平均要抽6.8张才出一张能用的;换成"单腿承重站立,右手插兜,左臂自然下垂,肩膀放松微侧",2.1张就出,这个差距乘以每天上百张的量,就是半天和一周的区别。
姿势词怎么写:动词、重心、手部位置三件套
一句合格的姿势词必须包含动作动词、重心在哪条腿、两只手在做什么,缺一项模型的随机性就放大一倍。这是87条模板迭代下来最稳的句式。
拿我库里的站姿模板举例:"侧身45度站立,重心落在左腿,右手插兜,左手轻拉衣角,下巴微收看镜头"。拆开看:动词是"站立、拉",重心写死了左腿,两只手各有去处。新手最容易写成"自然站立的模特","自然"这个词在模型那里等于没有信息,它只能随机给你拼一双手、歪一个重心,废片就是这么来的。
| 场景 | 姿势词模板(可直接抄) | 适用品类 |
|---|---|---|
| 站姿正面 | 单腿承重站立,另一腿微点地,双手交叠身前 | 连衣裙、大衣 |
| 站姿动感 | 行走中回眸,重心前倾,一手扶帽檐 | 风衣、套装 |
| 坐姿 | 坐凳前三分之一,腰背挺直,小臂搭膝盖 | 裤装、鞋类 |
| 半身特写 | 身体微转15度,单手托下巴侧面,眼神平视 | 针织衫、配饰 |
模板库里我最常用的只有11条,占出片量的六成多。摆姿跟真人摄影一个道理,耐看的姿势就那几种,别追求猎奇——你让模型摆"倒立拿大顶",它会很乐意,但衣服的物理逻辑全崩。
骨架参考和文字描述怎么配合
复杂姿势用骨架图控制结构,文字只负责补细节,参考权重压在0.45左右,两头都别下猛药。纯文字写不动、纯骨架又太死,配合才是正解。
手叉腰、坐姿盘腿这类姿势,纯文字描述的命中率很低,我会先找一张骨架参考图(火柴人软件两分钟就能摆一个),骨架管结构,文字管质感。权重我试过0.3到0.8整条区间:0.3以下骨架形同虚设,姿势照样乱来;0.6以上骨架是锁死了,但衣服跟着骨架绷直,褶皱全没了,像塑料模特。0.45附近是我跑出来的平衡点,结构听话,布料还活。
还有个土办法好用得超预期:拿真人摄影图当姿势参考。我把我以前拍的样片挑了几十张,只取构图和姿势,人物形象全换掉。这条路要提醒一句分寸——参考的必须是姿势结构,别连人家的构图水印、场景特征一起抄,版权和肖像的边界都在这里。
手、重心线、透视:三个高频穿帮的修法
我统计过384张废片,57%废在手部、26%废在重心线、17%废在透视,按这个顺序修,效率最高。三类的修法各不相同。
手部是重灾区,没有之一。修法从便宜到贵排:先在提示词里给双手安排明确任务(插兜、提包、扶帽),闲着的手最容易长出六根手指;不行的就上局部重绘,把手部区域单独重画,我修一次的成功率大约七成;还不行的直接放弃这张,别恋战。
重心线的穿帮更隐蔽:人是站直了,但从耳垂到承重脚踝画一条线,歪出去半只脚宽,观众说不出哪里怪,就是觉得假,划走了。检查方法简单,出图后眯眼看肩线和胯线是否反向倾斜——真人重心在一条腿上时,肩线和胯线是错开的,模型经常画成平行,一平行就僵。
透视穿帮集中在全身低机位:镜头写得太低,腿拉长到两米,裙摆却还是正常比例,整个人像踩了高跷。我现在的规则是全身照机位词只写"平视"或"轻微仰视",再低一律不碰,拉长腿的收益远抵不上比例崩掉的损失。
说到底,ai模特摆姿就是把我十年影楼里练的"看人"翻译成提示词:重心、手、视线,真人摄影师盯的三样东西,模型一样要盯。87条模板我还每个月淘汰几条补几条,摆姿没有一劳永逸的词库,只有一直跑、一直修的手感。你手里要是有一批出片率不高的图,先把废片按手、重心、透视分个类,修法全在这篇里了。
常见问题
不会摄影的人,怎么判断一张图的姿势好不好?
就查两处:从耳垂到承重脚踝画条线看直不直,再看两只手是否都有明确动作。这两处过关的图,八成能直接用,剩下两成是衣服细节问题,跟姿势无关。
同一个姿势用多了,会不会显得账号素材重复?
会。我的解法是一个姿势模板配三个变量:机位、场景、模特形象各换一档,同样一个"单腿承重站立"能翻出九种组合,买家基本看不出是同一个底子。
姿势参考图去哪里找?
两个来源:服装电商的销量前排实拍图(看姿势结构就好),加上自己用火柴人软件摆的骨架图。我从不用真人博主的照片直接喂模型,只提取姿势逻辑,这个边界要守住。
延伸阅读
- ai模特换动作实操:两条路线各跑两周,穿帮率说实话,管的是"同一套姿势怎么变着动",跟这篇的"姿势怎么定"正好接上。