家具ai模特姿势避坑指南:沙发坐姿、桌前阅读这些生活化摆姿怎么摆才不假
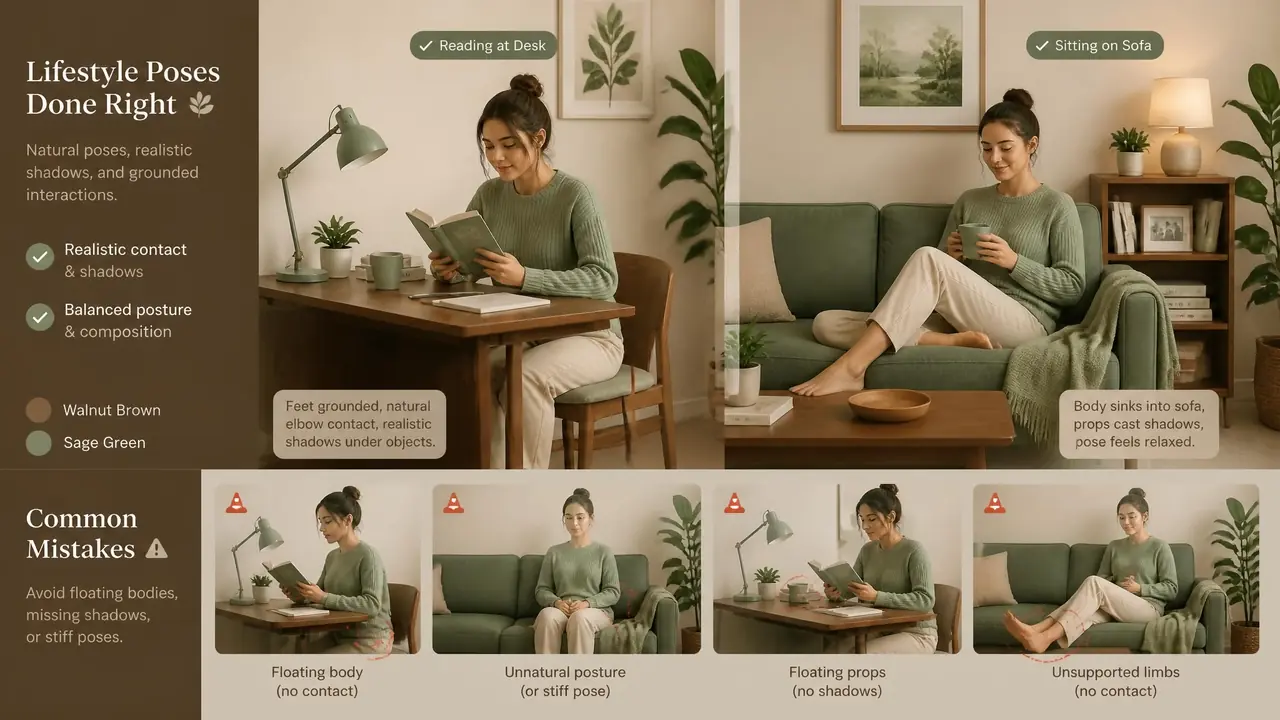
别绕弯子:家具场景里的AI模特图,假的根源多半不在人,在人和家具的接触面。屁股悬空三厘米、手穿进靠垫、后背贴着靠背却没一道压痕,观众一眼就出戏。我的做法是先写重心、再写动作、出图后只查接触面,成片率能从三成拉到七成。
家具ai模特姿势这道题,难的不是把人塞进画面,是让"坐下去"这件事看起来真的发生了。2026年9月我给一个做布艺沙发的店铺出图,头一版连出20张,能直接用的只有6张,问题清一色出在接触面:人像浮在坐垫上、裙摆没被压住、手搭在扶手上找不到着力点。调整提示词顺序之后,同样20张,能用的有15张。差别就在写法。下面按场景拆开讲。
沙发坐姿:先定重心,再定动作
沙发坐姿想逼真,先写"重心落在单侧臀部、坐垫出现下陷",再写腿和手。顺序反了,人就是贴在沙发上的一张纸片。
很多人写提示词的习惯是把动作堆满:侧身、翘腿、手撑头、微微歪头。姿势描述得越满,模型越顾不过来,最后每个动作都差一口气。我的写法是拆成三层。第一层写接触,"坐在米色布艺沙发边缘,重心偏向左侧,坐垫随身体出现自然下陷";第二层才写腿,"右腿自然弯曲踩地,左腿搭在右腿上";第三层补细节,"裙摆被坐垫边缘轻微压住"。这三层一句话写完也行,但接触描述必须放在最前面,模型的注意力分配就是靠位置体现的。
单人沙发和三人沙发要分开对待。单人沙发扶手高、坐垫软,人就写"窝进去":肩膀微微塌一点,腰后留一道空隙,这才像瘫着看书。三人沙发硬挺,适合写"坐前三分之一",腰背挺直,手放在膝盖上,气质立刻从居家变成卖场展示。我试过用同一套提示词换沙发,翻车翻得最惨的一次是给一张硬木框架的单人椅写"陷进坐垫",出来的图人整个沉到椅子框架底下,膝盖高过扶手,像掉进了坑里。
说实话,翘腿是重灾区。我20张里翻车的3张全栽在这:要么两条腿叠在一起长出三条腿的错觉,要么翘起的脚尖直接戳穿扶手软包。后来固定了一句"翘起的脚尖朝向镜头方向、离扶手一拳距离",翻车率才压下来。
桌前阅读:手是第二张脸
桌前阅读的难点全在手上:一只手压着书页、指节微微发力,另一只手搭在桌沿。手写活了,整张图就活了。
桌前阅读这个姿势,脸反而是最好出的部分,崩都崩在手。书是硬物,手指要贴着书页压出轻微弯折,指腹和纸面之间不能有缝。我现在的固定写法是"右手五指自然张开压住翻开的书页,食指与中指微微弯曲施力,左手手肘支在桌面、手背托住下巴侧下方"。两句话,各管一只手。
视线落点比手势还重要。很多图手没问题,但眼睛看镜头,那就不是阅读,是摆拍。写"视线低垂,聚焦在书页中段",整个人的状态会跟着变:脖颈前倾一点点,肩膀放松,连嘴角都会自然松下来。2026年9月那批图里,我做过一个小对比,同一套提示词只改视线描述,加"视线落在书页"的版本,客户选图率明显高一截,评论里有人专门说"这姑娘看得很专注"。
翻车经历也得交代。有一版我写了"手指翻动书页",出来4张,2张手是六根手指,1张书页直接从指缝里穿过去。AI画"动作进行中"的手特别容易崩,因为运动中的手指角度没法预测。解决办法是把动作写成"定格":不写翻页,写"指尖停在书页右上角、正要翻页的瞬间"。定格的手,五指结构稳定得多。
接触面自然度:出图后必查的三处
接触面出图后放大到200%只查三处:坐垫下陷、衣物褶皱方向、手臂与扶手的交叠边界。任何一处穿模,这张图直接重出。
为什么是这三处?因为AI最擅长的就是把接触面"糊"过去。人的臀部贴着坐垫,它不敢画清晰的压痕,就画一道模模糊糊的阴影,远看还行,放大一看人是悬空的。衣物褶皱同理,裙子被坐垫压住,褶皱应该从受压点向外放射;AI经常画成从腰上垂下来的自然褶,等于告诉你这块布没接触任何东西。
我把三个生活化场景的排查重点整理成一张表,亲测比逐条记提示词管用。
| 场景 | 最容易假的位置 | 提示词补写关键句 | 我的主观难度 |
|---|---|---|---|
| 沙发坐姿 | 坐垫下陷、裙摆受压 | 坐垫随重心下陷、裙摆被坐垫边缘压住 | 中等,翘腿易翻车 |
| 桌前阅读 | 压书页的手、翻页瞬间 | 五指压住书页微微施力、定格不写动作中 | 偏高,手部重灾区 |
| 床边倚靠 | 床垫软塌、脚踝与床沿交叠 | 床垫随体重轻微下陷、脚踝交叠处阴影加深 | 低,躺姿反而好出 |
修图只做一件事:补压痕和褶皱。把接触面局部放大,用修补工具沿受压方向拖两笔,坐垫上补一道浅浅的凹陷阴影,裙摆下摆压出一条受压折线。别多修。我第一版图修得太用力,坐垫凹陷深得像被石头砸过,客户直接打回来。两笔,浅浅的,够了。
话说回来,不是所有场景都值得这么抠。单人沙发出图25秒一张,翻车重出也就半分钟的事;但桌前阅读那种手部特写构图,重出三四张都未必出得来一张对的,这种才值得后期修。
写到这儿把开头的判断再收一遍:家具ai模特姿势的坑,九成埋在接触面。先写重心和接触,再写腿和手的动作,出图后放大查坐垫下陷、褶皱方向、手臂边界这三处,剩下的交给少量修补。姿势不用复杂,生活化的摆姿反而越简单越真。你按这个顺序写提示词,第一版的成片率就会不一样。
常见问题
没有真人参考图,只用文字提示词能摆出自然的生活化姿势吗?
能,但要接受前几版的浪费。我的经验是先只写接触层和腿的动作,出图确认坐姿成立后,再补手部和视线描述,分两轮收敛比一次性写满快得多。有真人参考图当然更稳,垫一张同姿势的照片当底图,姿势还原度会高一档。
姿势对了但模特不像客户要的类型,怎么办?
姿势和长相分开调。先把姿势锁定,用局部重绘只换脸和发型,别整张重出,否则好不容易调对的接触面又变了。另外提醒一句:请勿用他人照片冒充本人生成,肖像授权这条线不能碰。
人物和家具的比例不对,人显得过大或过小,能救吗?
先救提示词再救图。提示词里写清家具的具体规格,比如"三人位沙发、座面离地约40厘米",模型对尺寸的理解会准很多。已经出歪的图,比例差得少可以缩放人物图层硬拉,差得多就别救了,重出的成本更低。
批量出图时怎么让每一张都保持同一套姿势?
把验证过的提示词整段固定住,只换家具材质和配色描述,动作描述一个字都别动。再配合固定种子值,同姿势不同沙发的系列图一次能出八九张风格统一的。我那个沙发客户最后就是用这个办法,一下午出了全套主页图。
延伸阅读
- 全身ai绘画不断腿不切脚?画幅比例、留白与提示词写法——家具场景基本都要画到脚,画幅和留白这篇正好接得上。