AI模特变装怎么玩:从出图对齐到卡点发布的完整记录
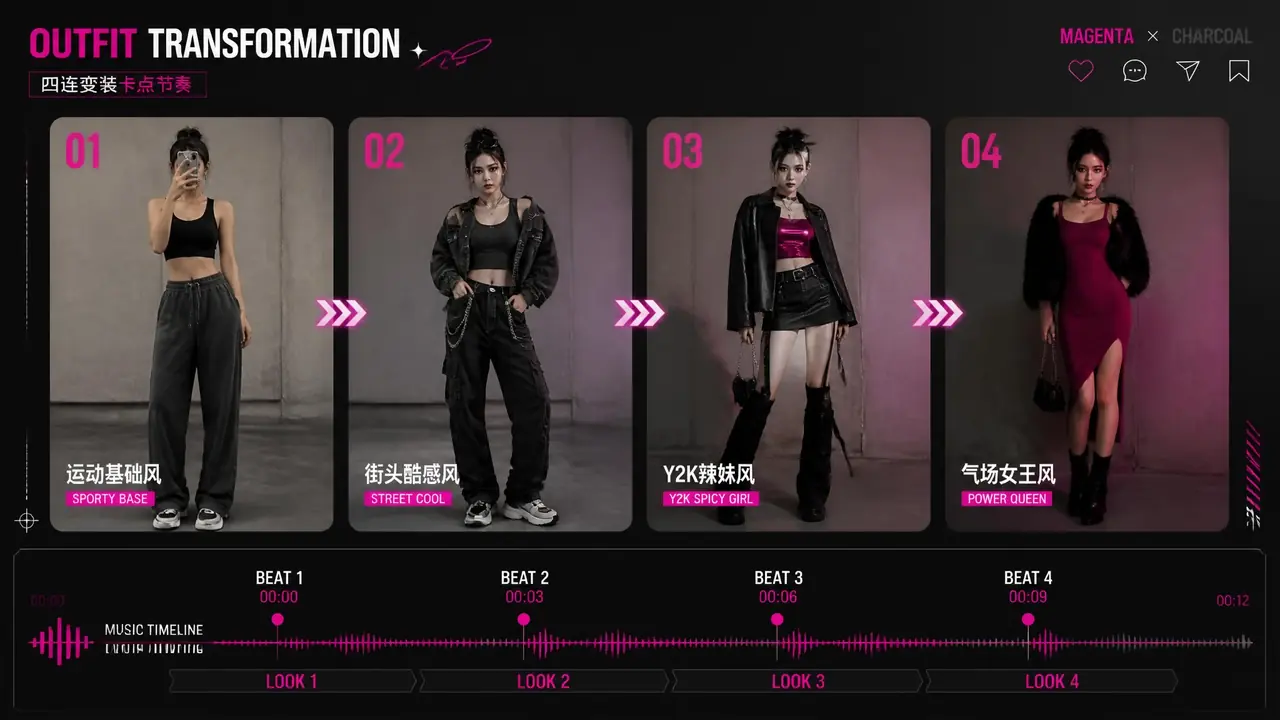
变装视频的流量,藏在转场前那0.8秒里。前后两帧的脸、手位、光线对不齐,观众半秒就划走。先用AI把两张模特图锁进同一构图,再进剪辑,卡点才有得卡。
AI模特变装这个玩法,大部分人做反了顺序:先剪视频,回头再补图,结果转场处处穿帮。我的做法是反过来——先把前后两帧静态图做到能骗过暂停键,剪辑只剩十几分钟的活。先说结论:变装视频的成败在出图阶段就定了七成,剩下三成才是卡点和音乐。
交代下身份:我自己在做一个2.3万粉的变装小号,主拍汉服和时装的切换,47条视频里跑出过一条8.7万播放的,也攒了十几条没人看的废片。下面这些坑,废片比我更有发言权。
先锁同一张脸,再谈变装
变装前后必须是同一个人:脸型五官全部锁死,只换服装和发型;脸一变,观众就当成两条视频,转场效果直接归零。
新人最常犯的错,是前后帧各生成各的,出图确实都好看,一转场,颧骨变了、眼距变了,评论区第一句就是「这俩不是一个人吧」。我的锁法是出后帧时把前帧垫进去当参考,描述里固定「同一位模特、同一正面角度、同一光线」,可变的词只留服装材质和发型两项。
垫图也不是万能。我有一条视频,前帧旗袍后帧西装,垫图垫了四轮,鼻子始终差一点,后来干脆把后帧的机位微调了三度,用视角差把那张脸「解释」过去了。观众要的其实不是像素级同一,是第一眼认得出同一。
姿势和光线对不齐,转场必穿帮
前后帧的手位、身体朝向、光源方向要尽量一致;差异只留给服装和发型,观众的眼睛一次只接受这两个变量。
我把十几条废片挨个复盘过,12条里有9条翻在手位。前帧手搭在腰侧,后帧手垂着,转场一闪,手像凭空换了地方,观感就是「剪错了」。出图时我会在描述里明确手部:「双手自然交叠在身前」或者「单手叉腰」,前后帧用同一句,一个字不改。
光线是第二杀手。前帧暖光后帧冷光,理论上像是「变装换了氛围」,实际剪出来是两张图硬切。光源方向必须一致——左前方打光就都左前方,强度可以变,方向不能变。背景我也踩过一次坑:前帧纯白棚拍,后帧手痒加了街景,转场时整个人像从照片里跳进现实,怪到没法看。现在背景词同样前后统一,色温差控制在肉眼无感的范围内,氛围统一交给剪辑里的调色,不交给提示词。
我现在的检查动作很土:两帧并排缩略图,眯眼看剪影,剪影对得上才进剪辑。就这一个动作,帮我毙掉了至少五六条本会穿帮的视频。
卡点不是卡在变装完成,是卡在变化开始
把转场帧对准节拍重音,0.8秒内完成切换;观众看到的「瞬间」其实是三四帧的过渡,重音落在第一帧,不在最后一帧。
那条8.7万播放的视频,卡点我改了六版才定稿。最大的心得是:重音要对上转场的第一帧,让人感觉「鼓响的那一下,衣服变了」。要是把重音对到切换完成之后,整条视频就慢半拍,弹幕会写「卡点卡了个寂寞」。切换本身我用三帧交叉溶解,总长压在0.8秒内,快到看不清过程,慢到不觉得是硬切。
数据上也验证过:同一段素材,重音落第一帧的版本平均播放完成率比落最后一帧的版本高出将近两成。差别就在那零点几秒,观众根本说不清哪里不对,就是划走了。
一条视频塞两次变装,完播率翻着涨
单条视频做两段变装,第二段卡在进度条七成处出现,完播率明显好于单段;塞三段以上反而掉,观众会疲劳。
我单段变装的那些视频,完播率平均在31%上下。后来试着在一条视频里做两段变装——开头一段,进度七成处再变一次——完播率涨到48%。观众知道后面还有一次变化,就舍不得划。第二段的位置有讲究,放在七成而不是结尾,是给算法留完播判定的时间窗口,贴着结尾变,数据反而没动。
三段我也试过两条,完播率掉回35%附近。变装的新鲜感是消耗品,一段是钩子,两段是节奏,三段就成了流水账。现在我固定两段,省心,数据也稳。
回到开头那句:AI模特变装玩法的胜负手,在按下发布键之前就已经写完。出图对齐做扎实了,剪辑就是体力活;出图糊弄,神仙卡点也救不回来。下次出图,先把脸锁了再说。
常见问题
AI模特变装视频的图用什么工具出?
任何支持垫图加参数锁定的生图工具都行,我目前在FlowPix里出前后帧,锁脸靠垫图加固定描述词。关键是工具要能重复生成同一人物,做不到这点的纯文生图工具别考虑。
前后两帧总是对不齐怎么办?
把机位写死:同一焦段、同一高度、同一距离,垫图参考前帧,重生成到剪影基本重合为止。我接受的上限是姿势误差不超过一个肩膀的宽度,超过就重出。
这类内容会被平台判定搬运或者低质吗?
自己生成、自己剪的原创内容不算搬运,我47条里没有一条被判过。要注意别拿热门模板的画面原样套,画面素材必须是自己的。
新号没粉丝,做变装内容还有机会吗?
我的号从零开始,前30条几乎没水花,第31条才起量,第4个月到2.3万粉。这个赛道吃的是单条质量不是账号权重,前提是你熬得过前30条的沉默期。
延伸阅读
- ai变身模特特效怎么玩不穿帮?变装号主理人的实测笔记,锁脸和对齐的进阶版打法。
- AI模特生成技巧拆到提示词一级:谁、什么光、什么镜头三段式,前后帧描述的底层结构。