ai T台模特出图实测:秀场感和废片率之间的拉锯战
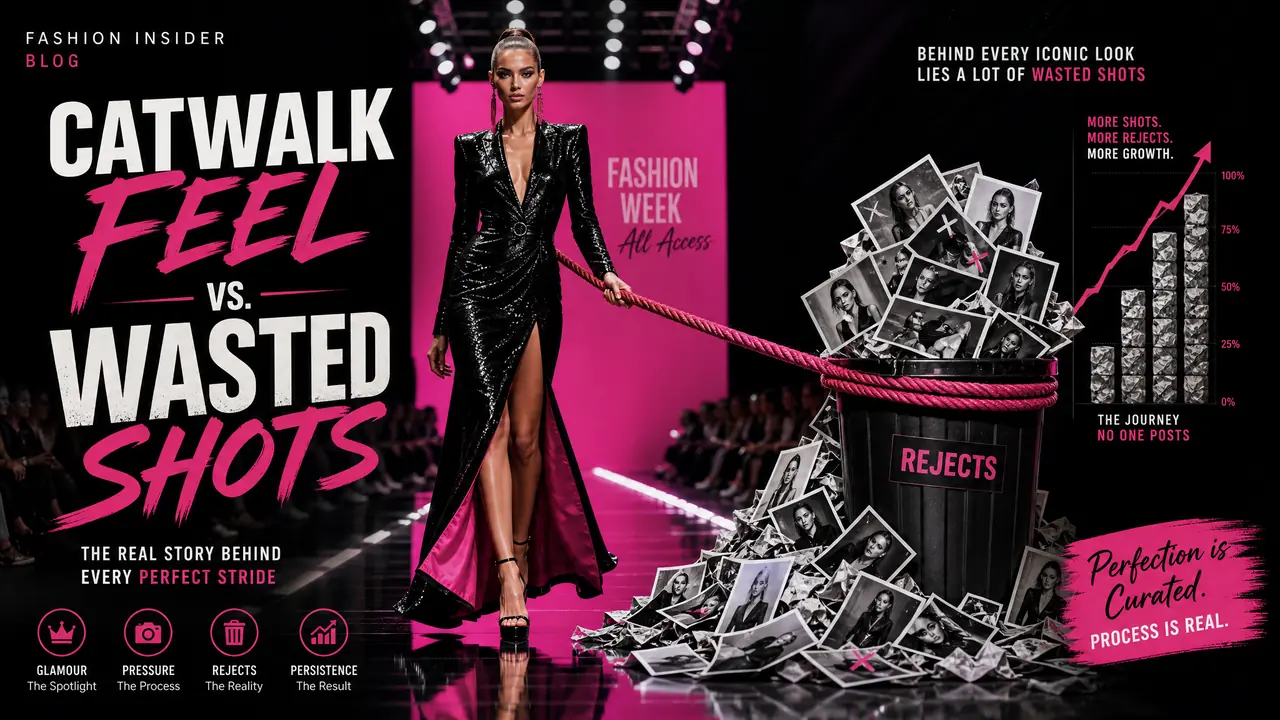
ai T台模特图的难点不在画人,在画"动起来的一瞬间":裙摆的惯性、追光的地面、虚掉的看台,三样齐了才有秀场味。我在工作室调了三周,把废片率和调法都记了下来。
工作室每季要做一本lookbook,往年按棚拍思路出图,图是好,就是闷。九月接了个急活,客户要"发布会的气势",我第一反应就是T台风。想法很美,动手才发现,AI画静止的人稳定,画走路的人是另一门手艺。
第一晚出了六十张,能看的四张。模特站着都是超模,一迈步全露馅:重心不对、裙摆和腿的动作脱节、看台观众糊成色块贴在半空。那晚我盯着屏幕想,T台图的灵魂到底是什么。想明白这个问题,后面的路才通。
秀场感从哪来,拆开就三样
追光、纵深、动态三要素齐了是秀场,缺一样就是影楼。反复对比真秀场图后我把秀场感拆成三件事:顶上要有一束追光,模特亮、周围暗;地面要有反光,T台的亮面地板是标志物;背景要虚,看台的暗部人影模糊但层次在。三样同时写进提示词,出图的"秀味"立刻出来了。头一晚的废片,问题全出在只写了"catwalk"一个词,AI理解的catwalk五花八门。
光线词我用的是"spotlight from above, reflective runway floor, dark blurred audience",中文平台对应写"顶部追光、亮面反光T台、虚化暗色看台"。有个细节,追光的范围要小,写"大面积舞台光"出来的就是歌舞厅效果,又得返工。看台的虚化程度也有讲究,全虚到底看着假,隐约能分辨一排排人影轮廓才是对的火候,我把这个火候调了两个晚上,参数是背景虚化强度卡在中等档,再往上人影就成了色块。
走姿的动态,是废片的重灾区
步态描述写关键帧不写过程,重心和裙摆分开控制,废片能压到四成。走路是最难生成的动作。直接写"走路",AI给出的步态千奇百怪,两腿交叉的、飘在地面上的。有效的写法是抓一个瞬间,"迈步中、前脚刚落地"这类关键帧描述,比"行走中"稳定得多。裙摆和腿部要分开交代:"裙摆向后扬起"加"步伐沉稳",两个词各管各的,混在一起AI就自由发挥了。
三周下来的数据:T台风废片率稳定在四成上下,是棚拍的两倍。这个成本要提前算进工时,我后来固定每晚先出二十张试探参数,参数对了再放量,不这么干就是烧钱。手部问题在T台图里反而少,远景加动态,手基本看不清,算是不幸中的万幸。脸部的一致性倒是省了心,镜头远,客户对脸的注意力天然弱,我拿棚拍篇那套锁脸流程略降权重就够用,省下的小半天工时全贴给了动态调参。
lookbook该用T台图还是棚拍图
开头两三页用T台图立气势,中间看款式的页面全用棚拍图,别一T到底。T台图好看不好用,这是三周下来最实际的结论。动态加暗光,面料的纹理和版型细节全被吃掉,客户翻看款式时需要的是清楚,不是气氛。我最后那本lookbook的结构是:封面和篇章页用T台图撑场,内页详情全部棚拍或场景图,客户翻完的反应比上一季明显好,两拨人夸的是同一样东西——"有品牌感"。
反过来,社交媒体和发布会的预热物料,T台图的完播率和转发都高于棚拍图,气势这个东西在手机小屏上特别吃香。两种图是分工,不是替代,想明白这一层的都省了冤枉钱。
棚拍图的基本功是T台图的地基,姿势和布光那套没有捷径,之前整理过一版按款式的姿势方案,可以套用。ai模特姿势控制的分款式方案
把T台图做成动态视频的思路也通了,图生视频的坑我另有一笔账。ai模特图生成视频的实测与坑位
那本lookbook交付那天,客户翻到封面那页追光下的走姿图停了几秒,问:这个场租不便宜吧?我说是AI画的,他愣住,又往回翻了两页。三周前那六十张废图里的每一张,都在这几秒钟里回了本。秀场感不是玄学,是三样要素加四成废片的耐心。
常见问题
ai T台模特图和棚拍图该怎么选?
封面、预热物料、社交媒体用T台图立气势,详情页和看款式的内页用棚拍图讲清楚,两者分工不替代。
走姿图废片太多有办法吗?
写关键帧不写过程,重心和裙摆分开描述,废片能压到四成左右,再低就得靠大量筛选。
追光会不会把面料颜色打失真?
会,强追光下面料偏色明显。主推款的正色图还是要在标准光下出,T台图只负责氛围。
没有看台背景能做T台感吗?
可以,追光加反光地面两样齐了就有七成味道,背景用纯暗色虚化,比画错的观众更干净。