ai模特生成技术到底怎么回事?一篇讲明白原理
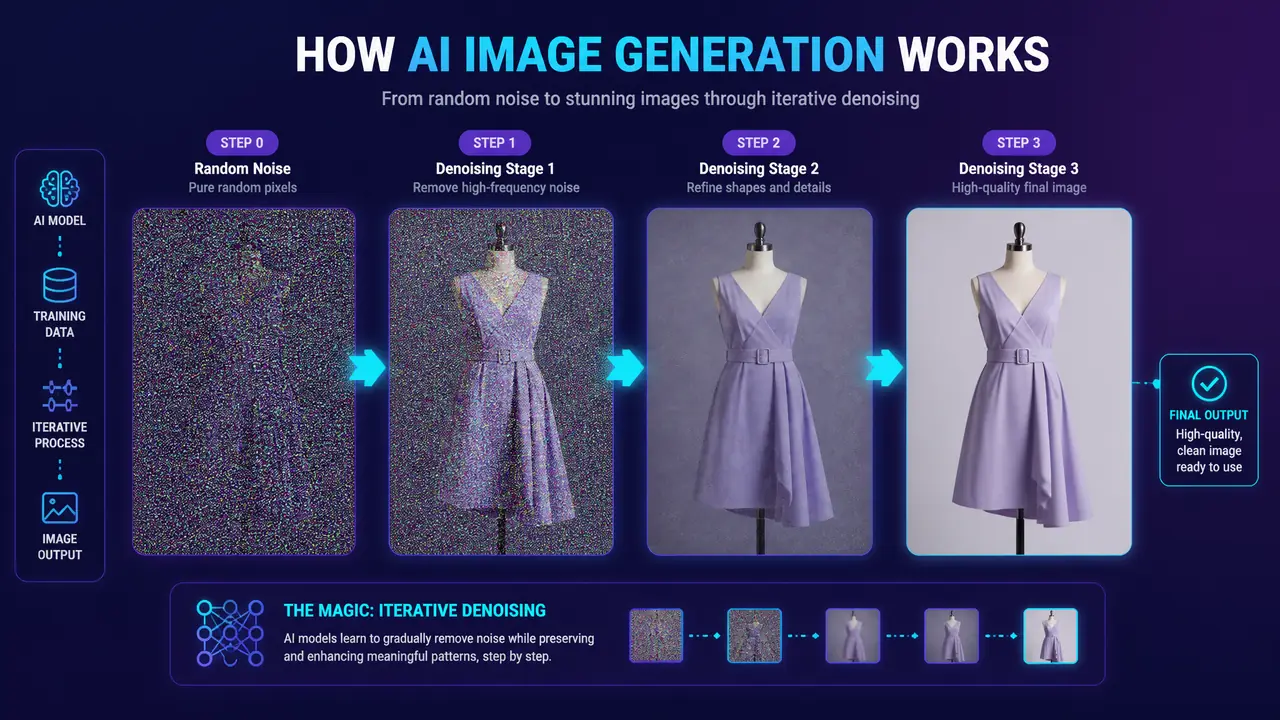
直接给结果:ai模特生成技术的核心就三样——扩散模型负责把噪点还原成图,参考图控制负责让画面听话,小样本训练负责造出一张专属脸。我做了两年女装图库,原理懂不懂,废图率差着一倍,这篇全用大白话讲。
ai模特生成技术这个词,听起来像实验室里的东西,其实拆开就三件事。我是美工出身,2023年底被公司安排搞AI出图,一开始纯靠抄别人的指令,图好图坏全凭运气。后来硬着头皮搞懂了原理,才算摸到门把。
这篇不堆术语、不贴论文,讲的都是我自己验证过的东西。你要是也天天出图,建议看完,调参的时候心里会有底。
先交代下我的日常。公司在杭州,女装类目,图库每月要补三千张上下,主推款、活动款、长尾款各占一头。这个量逼着我把原理吃透——纯靠玄学出图,三千张里能用的凑不齐一半。
从一张噪点图到成片:模型在干嘛
扩散模型的原理是"去噪":先学会把清晰图加噪点变花,再反过来学从噪点一步步还原。你每生成一张图,本质是模型从一团雪花点里"猜"出一张画。
你可以把它想象成修照片的反过程。平时修图是清晰变干净,它是把一团电视雪花屏,按你写的文字提示,一步步擦出人、衣服、背景。擦的步数就是你设置里的"采样步数",我实测20到30步足够,再多画质提升有限,时间翻倍。
这也解释了一个常见疑惑:为什么每次生成的图都不一样?因为起点是一团随机噪点,起点不同,终点就不同。所谓固定种子,就是固定了那团噪点,脸自然就稳了。
顺便说,手为什么总画崩?训练数据里手千姿百态,握拳、比心、插兜,模型学不齐。给手安排个简单动作,本质是帮模型缩小范围。
文字提示词在其中的角色,可以理解成"擦图的方向盘"。你写什么,模型就往哪个方向擦。写得模糊,它就自由发挥;写得具体,它就老实照办。所以指令的功夫,一半在描述服装,另一半在描述画面。
让同一张脸反复出现的三种办法
锁脸三条路:固定种子加同段描述、垫参考图控制、用几十张图训练专属小模型。成本递增,稳定性也递增,按店铺体量选。
第一种最省事,种子固定,描述开头带上同一段外貌描写。缺点是换姿势、换场景容易跑脸,适合小批量。第二种是垫图,喂一张基准脸让模型照着画,我对着垫图跑出的相似度大概七成,姿态变化大时偶尔还是会飘。
第三种是训练专属小模型。去年8月我试过一回事:攒了五十多张同一虚拟形象的图,训练跑了不到一小时,出来的模型对这张脸的还原度明显高于前两种,代价是要会一点基础操作,还要留出试错时间。我们店现在主推款用第三种,长尾款用第一种,混着来。
懂原理能帮你解决什么实际问题
懂原理最大的价值是出问题时知道往哪查:脸崩查种子和步数,构图歪查参考图权重,风格飘查训练数据。不用每次都干等重跑。
举两个我自己的例子。有阵子出的图全偏暗,换成以前只会重跑,后来明白是描述里"夜景"这个词权重太高,删掉就正常。还有次垫图出来的模特脸总带参考图的妆,把参考图权重从0.8降到0.6,脸保住了妆也卸了。
原理还帮省了不少冤枉钱。知道步数20够用之后,我把批量出图的参数统一调低,单张耗时从35秒左右降到20秒出头,一个月跑几千张图,省下的时间相当可观。
要说门槛,其实没那么高。美工出身算有点底子,但真的只是"有点",教程我看的是公开的免费资料,剩下的全靠反复试。两年下来我最大的体会:这行不缺会打字的,缺懂一点原理、出问题不慌的人。
身边问我最多的一个问题:要不要专门报班学。我的经验是原理层的内容免费资料就够了,花钱该花在算力上,不在知识上。把省下的学费换成出图额度,多跑多废多复盘,比什么都快。
写完这篇抬头看了看出图队列,还有两百多张在跑。技术这东西,了解原理不等于要成为工程师,够用就好。就像开车不必懂发动机每个零件,但知道油门和离合是怎么回事,爬坡就不熄火。你的出图废图率要是降不下来,八成就是还差这点"原理税"。
常见问题
AI模特生成需要懂编程吗?
不需要。固定种子、垫参考图都是现成功能,训练专属小模型也只要基础操作。我是美工出身,两年下来没用过一行代码。
为什么AI模特每次生成的脸都不一样?
因为每次起点是一团随机噪点。固定种子参数等于固定起点,再配同一段外貌描述,脸就能稳住。
训练一个专属模特形象要用多少图?
我去年8月试过五十多张同一形象的图,训练不到一小时,还原度比垫图高不少。图贵在统一,不在多。
出图步数设多少合适?
20到30步足够,我实测再多画质提升有限但耗时翻倍。批量出图统一用低步数,单张时间能省下小一半。