ai指导模特摆姿势,手位视线构图指令这样下
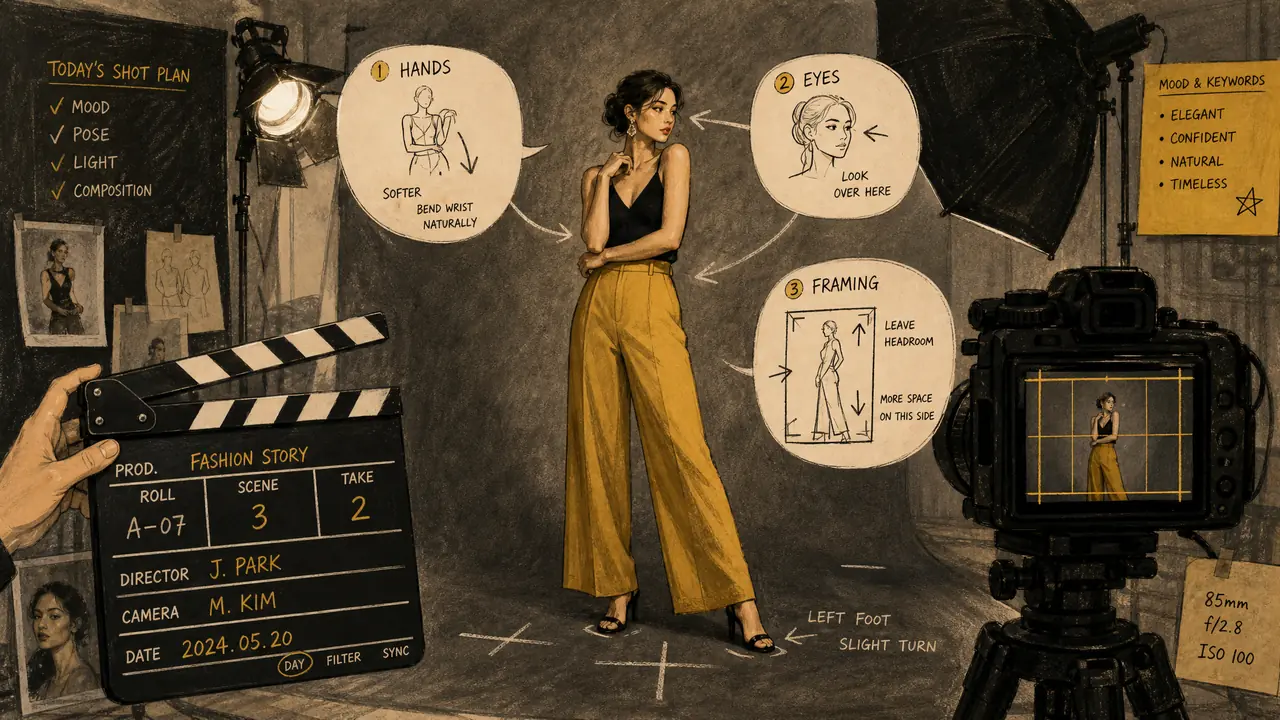
把丑话说前头:ai听不懂摄影师黑话,你写得越专业它摆得越僵。指令要像给真人讲戏,一次一条,我三类指令各跑20张,命中率都记在下面。
ai指导模特摆姿势这件事,本质是你当导演、它当演员。我的结论:指令写成日常口语,一次只给一个动作,命中率能翻一倍;写成“低机位广角、三分构图”这种行话,出图基本靠抽。
头一回我按摄影教程的术语写了一整段提示词,出来的模特胳膊肘反关节、站姿僵得像证件照,30张里能看的3张,还都是手插袋的,算是意外摸到第一条规律。之后我改了路子,把手位、视线、构图拆成三类指令,各跑20张做记录,什么好使什么不好使,全有数。
手位指令先摸清底细
手位指令命中率整体偏低,双手插袋12/20最稳,提裙摆5/20最难,动作越具体到左右手越容易成。手是全身最容易崩的部位,值得单独说。
实测数字摆这儿:双手插袋12/20,单手叉腰只有9/20,写成“左手叉腰、右手自然下垂”之后涨到13/20,说明它吃“具体到哪只手”这套。插袋也有讲究,写“双手插牛仔裤前袋”比单写“插袋”准得多,不写前后袋,手肘能顶出奇怪的角度。最难的是提裙摆,5/20,手指捏布料的动作太细,崩出来的手不是六指就是穿进裙子里。劈叉、盘腿这类大动作我直接放弃了,出图耗的时间比修图还多。
我的处理分两层:批量出图时压根不用提裙摆这类细动作,宁可站姿素一点;非要用,出完先放大看手,救不回来的直接重出。手部修复的细节功夫,我照着ai珠宝模特手部总崩图?微距细节与绒布衬底调法那套微距修法练的,修一只手两三分钟。
还有条铁律:一条指令只带一个动作。“插袋加歪头加抬脚”三连,20张里崩了13张,拆开一条条来,崩率立刻掉下去。
视线和表情要写明方向
“目光平视镜头”最稳,“低头看手中物”容易眼神飘,视线必须跟头部朝向配套写,不然翻白眼都出得来。表情指令宁少勿多。
稳的表达我筛出三个:目光平视镜头、闭眼仰头、低头看手中物。前两个命中率都在15/20以上,第三个容易眼神飘,看花能看成斗鸡眼。翻过一次车:我写“眼神望向远方”,出了2张翻白眼的,要么瞳孔上翻要么直接闭反了。表情我只写微笑和冷淡脸两类,写“自信的笑容”这种虚词,出来4张龇牙咧嘴的。
救法是视线跟头一起写:“头部微侧、目光平视镜头”,头部朝向定了,眼神就不乱跑。怪表情还有斜视和双瞳孔两种,处理思路相同。真出了怪表情别急着重出,先局部修脸,五官的修图顺序我按模特美女ai生成图太假?五官精修顺序和参数,照抄就能用那篇来的,眼睛最后动,动早了全脸歪。
构图指令的翻译对照
摄影师术语要翻译成大白话它才懂,全身入镜、上方留少量空白这类写法,命中率比专业行话高出近一倍。下面是我试出来的对照关系。
| 我原来写的行话 | 翻译后的大白话 | 命中率变化 |
|---|---|---|
| 全身景、脚下留白一成 | 全身入镜,脚下方留一点空 | 11/30 到 22/30 |
| 低机位仰拍 | 从下往上拍,腿显长 | 8/20 到 14/20 |
| 三分构图主体居右 | 人站在画面右边,左边留空 | 9/20 到 17/20 |
翻译的关键是把“比例、方向”说成人话,别堆参数。景别上七分身最适合详情页,全身图压到详情页宽度后脸太小,我现在七分身占六成。还有个偷懒法:先出一张姿势对的素图存着,往后同姿势只换服装描述,连指令都省了。一组姿势20张,筛加重出25分钟,指令写得准,这25分钟能压到一刻钟,店里的上新节奏就不容易被出图卡住。
说回开头的结论:把ai当新人模特带,讲人话、一次讲一件事,它比你想的听话。手位挑稳的下,视线连着头部一起写,构图说方向不说术语,三招用上,僵脸证件照姿势基本绝迹。上个月帮朋友的童装店调了一版,同一套思路照搬,第一天命中率就过了六成。我现在的提示词模板就一屏纸,新来的兼职能照着出图,这事没有玄学,全是记录出来的手感。
常见问题
坐着拍摄的姿势指令好使吗?
凳子类姿势中等难度,坐姿加手放膝盖大概10/20。椅子扶手、桌沿这些它经常画错位置,我用得少,站姿够详情页用了。
指令用中文还是英文命中率高点?
我用中文没觉出差别,工具本身做了翻译。你非要写英文也行,关键是句子短、一次一个动作,语言不是瓶颈。
姿势模板可以存下来复用吗?
可以,我把命中最高的十几条存了个文档,换品类只改服装描述那一段,姿势段原样搬,命中率基本不掉。
一张图里能同时改姿势和换背景吗?
别。姿势和背景分开调,一步验证一步,两个一起改,出了问题你都不知道是哪句指令惹的祸。