ai模特表演图怎么出?动态走秀姿势全流程与翻车实录
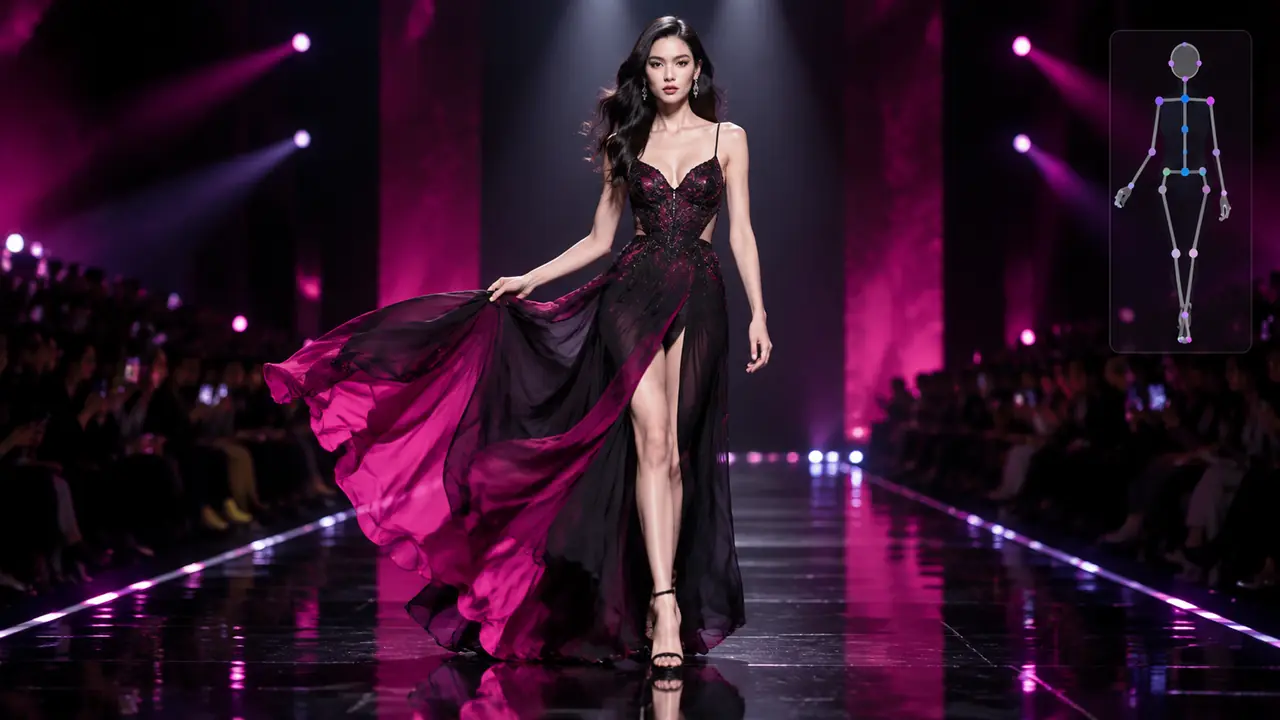
直接给结果:ai模特表演图想不崩,先锁骨架,再谈氛围。动态姿势直接文生图十张崩八张,姿势垫图加0.35以下重绘幅度才是正路。三条技术路线的成本账也给你算好了。
ai模特表演图,指的是那种带动作的模特图——走秀迈步、转身提裙、回眸、抬手撩发。静态摆拍AI已经很稳了,一动起来就完全是另一门手艺。我的判断放在开头:动作幅度越大,越不能裸靠提示词,骨架控制得先上。
我为一个女装店做过一组"走秀风"详情页图,第一晚裸写提示词,"模特迈步走秀,裙摆飞扬",连出二十张,能看的四张,手全在抽搐。第二天换了姿势垫图的路线,同样二十张的量,能看的十一张。差距就是这么直白。
动态姿势全流程:先锁骨架再谈氛围
流程四步:姿势参考图定骨架、重绘幅度0.35以下、光源按舞台逻辑写、连拍用同一垫图串场。顺序别倒,氛围永远排在结构后面。
第一步找姿势参考。我不自己画骨架,直接拿秀场摄影截图当姿势垫图,走步、转身、提裙各存了三张常用的。垫图权重0.7,高一点没关系,这一步只要姿势,画面会被重绘洗掉大半。
第二步重绘幅度压到0.3到0.35。高于0.45,模型开始自由发挥,手指和膝盖重灾区;低于0.25,参考图的衣服版型又会渗进来。这个区间我调了整整一个下午,别嫌数字精确,差0.05就是能不能用的区别。
第三步写舞台光。顶光加两侧追光是走秀的标准配置,提示词写"顶部聚光灯、深色T台、观众席虚化"就够了。这里有个坑:写"舞台灯光"四个字不带位置,模型会给你四面开花的光,热闹得像夜店开业。
第四步是连拍串场。一组详情页要迈步、转身、回眸三张连贯的,我固定用同一张脸的定稿图当面部垫图,三张动作各配各的姿势图。出图尺寸1024乘1536,精修放大一倍,我这张卡一张要18秒,比静态图慢三成。
负面提示词在动态图里比静态图更重要,我固定挂三样:多余的手指、畸形的腿部、布料穿插。有一次忘挂"多余的手指",一整批二十张张张带六指,一晚上白干,这种低级亏吃一次就够。
翻车实录:手、裙摆、连拍接不上、透视畸
动态图四大翻车点:支撑手崩坏、裙摆穿模、三张连拍脸对不上、广角透视把腿拉畸形。每个都有对应解法,多数不用整张重来。
手是最高频的。提裙这个动作必须有一只手抓裙摆,十张里七八张手指纠缠成一团。我的土办法是让另一只手自然下垂不持物,抓裙的手出图后单独局部重绘,命中率能拉回六成。
裙摆穿模排第二。转身动作里裙摆会和腿穿到一起,布料逻辑是硬伤。实测长裙转身的失败率比短裙高一大截,所以主推长裙的转身图,我会把动作换成"起步回眸"这种裙摆滞后小的姿势,绕开硬伤。
连拍一致性是最近才栽的跟头。三张图单看都好,拼进详情页发现脸型不一样,一个颧骨高一个下巴尖。修法就是前面说的面部垫图锁脸,另外固定同一个种子值,别每次随机。
透视畸变最冤枉。为了舞台感写了"低机位广角",腿是被拉长了,长得不合常理,评论区真有人问是不是修图修坏了。后来我把低机位改成平机位加长焦压缩感,腿长感还在,比例正常了。说真的,动态图机位收敛点,比戏剧感重要。
三条路线怎么选:成本和稳定性摆一起看
结论:静态展示直接文生图,关键动作上骨架控制,要视频感才用模型抽帧。别一上来就冲最贵的路线。
| 路线 | 单张成本 | 稳定性 | 我的主观评价 |
|---|---|---|---|
| 直接文生图写动作 | 几毛钱 | 低,靠抽卡 | 试姿势可以,交付别用 |
| 姿势垫图加骨架控制 | 一块上下 | 高 | 性价比之王,我的主力 |
| 视频模型抽帧 | 3-8元/段 | 中 | 动态封面专用,贵在可控 |
我现在的分工:详情页用骨架控制的静态图,短视频封面用视频模型抽帧抽十几帧挑一张。时间上骨架路线一张从垫图到出图约三分钟,熟练以后一组三张一小时内收工。走秀机位、景别这些写法,和导演式提示词那套是相通的,我把一篇讲分镜和机位的文章翻出来对过,直接能迁移。
回扣开头的判断:ai模特表演图的核心是先锁骨架再谈氛围,姿势垫图、低重绘幅度、面部垫图串场,这三件套立住了,动态图就从抽卡变成流水线。你先用"起步回眸"这个最稳的动作试一轮,比直接挑战大转身划算得多。
常见问题
生成的走秀图能说是"秀场同款"吗?
不能。图是AI生成的,没办过秀就是没办过,宣传口径写"秀场风"或"走秀风"更稳妥,虚假宣传的锅比技术问题重得多。
动作幅度大的图还有必要做吗?
有,但放对位置。大动作图适合详情页头图和短视频封面,小动作图做补充。我的习惯是一组里只放一张大动态,其余收着来。
需要真人模特授权吗?
姿势参考图用秀场摄影时注意别把可识别的真人脸带进出图,生成的脸也别冒充真人做宣传,这两条守好就行。