视频模特ai图生视频实测:哪些动作能做,哪些一做就崩
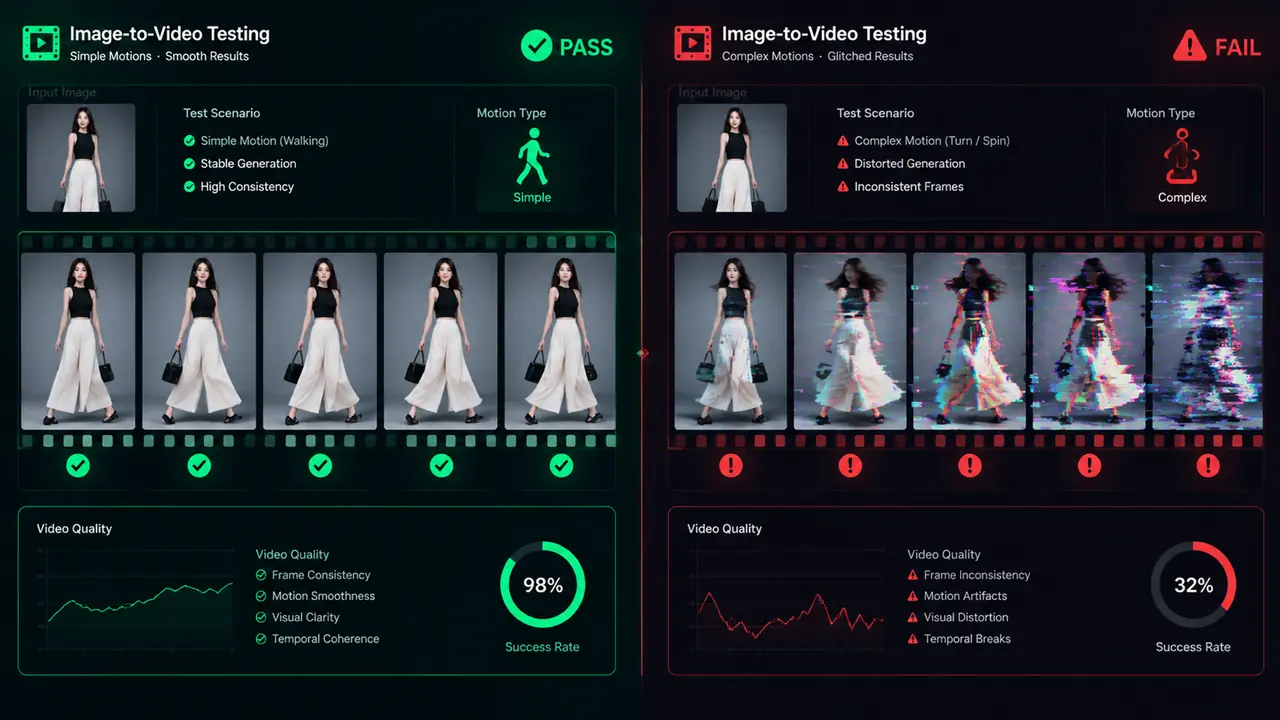
不绕弯子:图生视频扛得住小幅度的活,扛不住手指、字母印花和产品交互。你要做的是把镜头拆开,一段只含一个动作。先从呼吸感和裙摆动效这种最稳的试起。
视频模特ai这件事,我是拿废素材喂出来的心得:能让模特动起来,跟能让模特动得对,中间差着二十段学费。图生视频看着门槛低,丢一张图进去就出片,真到交付那天,你手里攥着一堆「手臂多出一截」的视频,不知道怎么跟客户开口。先记一句:动作越小,越稳。
8月底一家连衣裙店要主图视频,12 个 SKU,每个交一段 5 秒。我前后生成 40 多段,能直接交付的 17 段,剩下全是学费。这批素材让我把「能做」和「别碰」分得干干净净,现在接单先拿这份单子把客户的需求过一遍,能省下不少来回。
能稳住的动作,拢共就这么几类
呼吸感、轻微回眸、原地慢走、裙摆和头发的飘动,这四类是目前最稳的动作,出片率能过一半。
为什么是这几类?它们的共同点是躯干不动或者缓动,画面里没有新的几何结构进场。模型要「发明」的东西越少,崩得越少。呼吸就是胸腔起伏一两个像素的事,它画不好这个,别的也别指望了。
| 动作 | 稳不稳 | 崩点在哪 |
|---|---|---|
| 呼吸、轻微晃动 | 稳 | 几乎没有,打底用 |
| 回眸、转头 15 到 30 度 | 较稳 | 角度一大,脸会糊一下 |
| 原地慢走两步 | 看图 | 腿部关节偶发抽动 |
| 裙摆、长发飘动 | 稳 | 风一大,布料飘成布条 |
| 抬手撩发、比手势 | 崩 | 手指数量失控 |
| 拿产品、整理衣领 | 崩 | 产品变形,卖点没了 |
8月底那批里,前四类动作我投了 28 段,成了 15 段,出片率五成多。慢走有个小窍门:起始姿势别给「站定」,给一个像走路中途的架势,模型接着往下走就顺;给站定姿势让它自己起步,步子大概率顺拐。
回眸这条多说一句。转头角度给到 15 到 30 度是甜区,脸型只有轻微的透视变化;一过 45 度,下颌线会短暂「融化」一帧再拼回来,缩略图上像噪点,放大看就是事故。所以分镜时我把回眸安排在镜头前半段,真崩了,重抽的成本也小。
一做就崩的三种情况,我都替你踩过了
手指、字母印花、产品交互是三大雷区。手指会多会融,字母会蠕动变形,产品一变形卖点就没了,这三类要么绕开要么换拍法。
先说手。撩头发是重灾区,五根变六根,或者两根融成一根,逐帧看全是惊吓。我的规矩现在很死板:镜头里的手要么保持初始姿势,要么干脆出画,让它在画面外面待着,别给它戏。
再说印花。带字母的 T 恤进了视频,字母就像活的,一笔一划各自扭动,图越大扭得越欢。40 多段废素材,一半以上栽在这。我的替代方案:纯色款上视频,印花款用静态图加轻微动效糊弄过去,观感反而更稳。客户要是坚持印花款要动,我先出一段让他看字母蠕动,他自己会改主意。
最后是产品交互。拿包、拎袋、拧瓶盖,这类动作里产品是被模型当作「可以重画的区域」处理的,轮廓一漂,卖点全无。手包变形成一坨的镜头我出过不止一次,从那以后拿产品的镜头我只保留静态帧,动的部分交给背景和布料。
我现在的工作流:一段一个动作,三段抽一段
一段视频只给一个动作指令,别把转身加抬手加微笑叠在一起。每个镜头生成三段选一段,交付前逐帧过一遍手指和印花。
指令叠加是崩的头号原因。「转身并抬手微笑」,模型只能猜哪个动作优先,猜错就扭成麻花。9月中旬我把手头的记录整理了一下:单动作指令的段落,成片率三成多;叠两个动作,掉到一成上下;三个连写的基本可以不用等出片了。一段一个动作,是拿废片换来的纪律。
成本账也摆一下。12 个 SKU,每个镜头三段抽一段,单段 5 秒的片子生成要等 2 到 4 分钟,排队加挑片,两天干完,中间还能穿插改静态图。三段抽一不是我奢侈,是一段成片的运气不可控,预算里没这一项的团队,建议把它算进去。
交付前还有一道关:0.5 倍速逐帧过,盯三样——首帧像不像原图、手指对不对、印花有没有蠕动。客户打回最多的一条其实是首帧,视频第一帧和给他的静态图对不上,他默认你偷换了模特。首帧还原这个细节守住了,返工少一大截。
回到开头那句:动作越小,越稳。视频模特ai眼下干的是「让图多活五秒」的活,不是拍大片,别拿电影分镜的要求去为难它,也别为难自己。把动作清单和雷区背熟,这活就能接。
常见问题
图生视频出来的人脸,和原图会差多少?
首帧基本是原图,往后每一秒都在轻微漂移,5 秒的片子结尾和开头对比,五官能感觉到「松」了一点。我的做法是镜头动作设计得短而轻,别让漂移有时间累积,长镜头拆成两段剪,比一段硬扛稳得多。
主图视频的时长和规格有什么讲究?
平台规则一直在变,我按当时的平台要求现查,这块不敢凭记忆替你打包票。经验上 5 秒左右、首帧即封面的做法最省事,视频被压缩成封面图时也不难看。规格交片前对照平台文档核一遍,比事后打回强。
崩掉的段落里,手指问题能靠后期修救回来吗?
单帧能救,整段救不了。视频里手指是逐帧变化的,你修好了这一帧,下一帧又错,成本远超重生成一段。所以手指问题我不修,直接换动作重出,只有定格用的封面帧才值得精修。
手里没有模特原图,能直接文生视频吗?
能出,但我不建议走这条路。文生视频等于脸也交给模型抽卡,首帧就不受控,客户要的是「跟静态图同一个模特」,对不上就白干。正确顺序是先用图生图把静态模特图定稿、客户确认,再上视频,多一步确认,少一堆返工。