ai模特动画怎么做?一张图到5秒主图视频的全流程
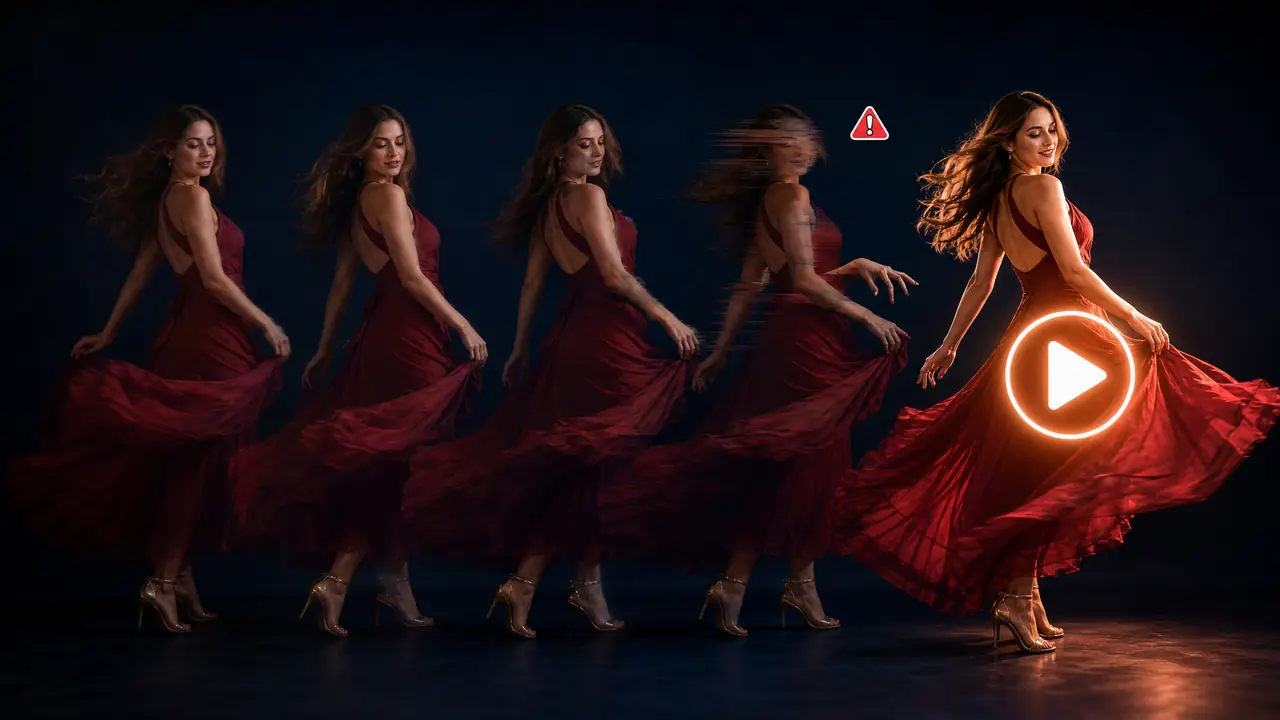
别绕了:ai模特动画最省事的路子是图生视频,一张成片丢进去写清镜头动作,5秒一条几分钟出片;要精确走位再上首尾帧插值。动作幅度写小、单段不超5秒、首帧用放大过的图,三条保命设置能少废一半。
ai模特动画这事,看着玄,其实就是把一张成片丢进图生视频模型,写清楚镜头怎么动、人怎么动。结论先给:主图视频和短视频开场,图生视频完全够用;要精确走位,才要上首尾帧插值。
上个季度给一家连衣裙店铺做主图视频,静态图客户早就有,就差"动起来"。我用图生视频跑了18条5秒的转身镜头,6条能用,单条成本折下来几毛到两块,比租棚拍一天两千块的账好看得多。翻车也翻得干脆:脸漂移、手指拧麻花、裙里穿模,一条不落全遇上了,下面把躲坑的路子讲清楚。
两条路线:图生视频省事,首尾帧插值可控
图生视频丢一张成片写镜头提示词,几分钟出5秒片段;首尾帧插值给两张图让模型补中间,走位准但费工夫。主图视频选前者,叙事短片选后者。
图生视频的逻辑是"看着办",你给镜头语言,模型自由发挥中间过程。可灵、即梦这类平台都支持,5秒一条,快的话两三分钟出片,高峰期要等十来分钟。首尾帧插值是"照着演",给起点和终点两张图,模型补中间的过渡,走位完全按设计来,废片率低,但首尾两张图都得自己先做好,工夫翻倍。
| 路线 | 耗时 | 废片率 | 我的用法 |
|---|---|---|---|
| 图生视频 | 2-10分钟一条 | 三分之二左右 | 主图视频、开场镜头 |
| 首尾帧插值 | 翻倍,要备两张图 | 三分之一以下 | 指定弧度的转身走位 |
我的倾向很偏:九成电商需求,图生视频就到头了。主图视频就5到9秒,观众划走只要半秒,没人细究转身的弧度是不是精确到度。
全流程实测:白底转身镜头跑了18条
流程四步:备首帧、写镜头提示词、批量生成、抽检拼接,18条里成6条,废片集中在脸、手、裙摆三处。每一步都有能省积分的细节。
首帧质量决定一半成败。我用放大到2048像素的成片当首帧,对比批次直接丢1024原图,脸部漂移明显更多,边缘糊的地方模型会自己"脑补",越补越歪。提示词有个原则:动作写小不写大。"模特缓慢向左转身四分之一圈,裙摆自然摆动,镜头固定"这条出片率最高;写"模特华丽转身"的,十条里八条裙摆穿模。
18条的账单:单条5秒,按平台积分折算几毛到两块,具体看会员档。6条成片里4条用的"缓慢转身"提示词。废片12条的理由我记得清楚:5条脸漂移,转到一半五官换了个人;4条手指拧麻花,抬手类动作是重灾区;3条裙里衬穿模,裙子转到一半凭空多出一层。还遇到过一回耳环消失又出现,跟静图时代的毛病一脉相承。
保命设置与拼接:把废片率压下去
三条保命设置:动作幅度写小、单段不超过5秒、首帧用放大过的成片;拼接交给剪映,转场用叠化。照做能少废一半。
展开说这三条。动作幅度写小,是把"转身360度"换成"四分之一圈",把"走起来"换成"重心轻微移动",模型对小幅动作的物理理解靠谱得多。单段不超过5秒,因为时间越长漂移越狠,5秒是各家模型普遍稳得住的区间,要9秒就两段拼接,别硬生。首帧用放大过的成片,理由前面说了,糊的源头只会更糊。
拼接环节剪映就够用,转场统一叠化,硬切会暴露两段之间服装细节的微小差异。主图视频的硬要求我也对过了:比例1:1或3:4,时长9秒内,体积别超平台上限,导出用30帧别用24帧,手机端观感差一截。音效先别加,主图视频多数场景静音播放,白费劲。
姿势的底子打不好,动画也救不回来,转身好不好看,七成看首帧的姿势选择,这部分在ai模特姿势的全流程控制那篇里拆过。
首帧本身的清晰度是另一道关,放大和分辨率的事看模特ai画图的放大流程那篇,首帧清楚了,漂移都能少一半。
回到开头的判断:ai模特动画没有玄学,就是把成片喂给图生视频,再把动作幅度、时长、首帧质量三件事管住。18条成6条的废片率听着心疼,摊到账上还是比棚拍便宜一个量级。先拿一张你最满意的静图试5秒,跑通这条链路,主图视频这个占位就补上了。
常见问题
生成的模特视频可以商用吗?
平台会员条款一般覆盖商用,但人脸授权要自己兜底,用签约模特的脸就留好书面授权。上线前把条款截图存档,别裸奔。
为什么视频里的脸会变成另一个人?
长镜头加大幅度动作最容易脸漂移,模型在中间帧自由发挥过头了。缩短单段时长、把动作写小,八成能压住。
一条5秒视频实际花多少钱?
按积分折算几毛到两块一条,看会员档位。批量跑先试两条再放量,我见过有人一口气烧几十条全废的。
平铺图能直接做成动画吗?
不推荐。平铺图没有人体结构,动起来像布料成精。先转成模特图,再进动画流程,顺序别反。