4080跑ai绘画实测:SDXL出图速度与显存全记录
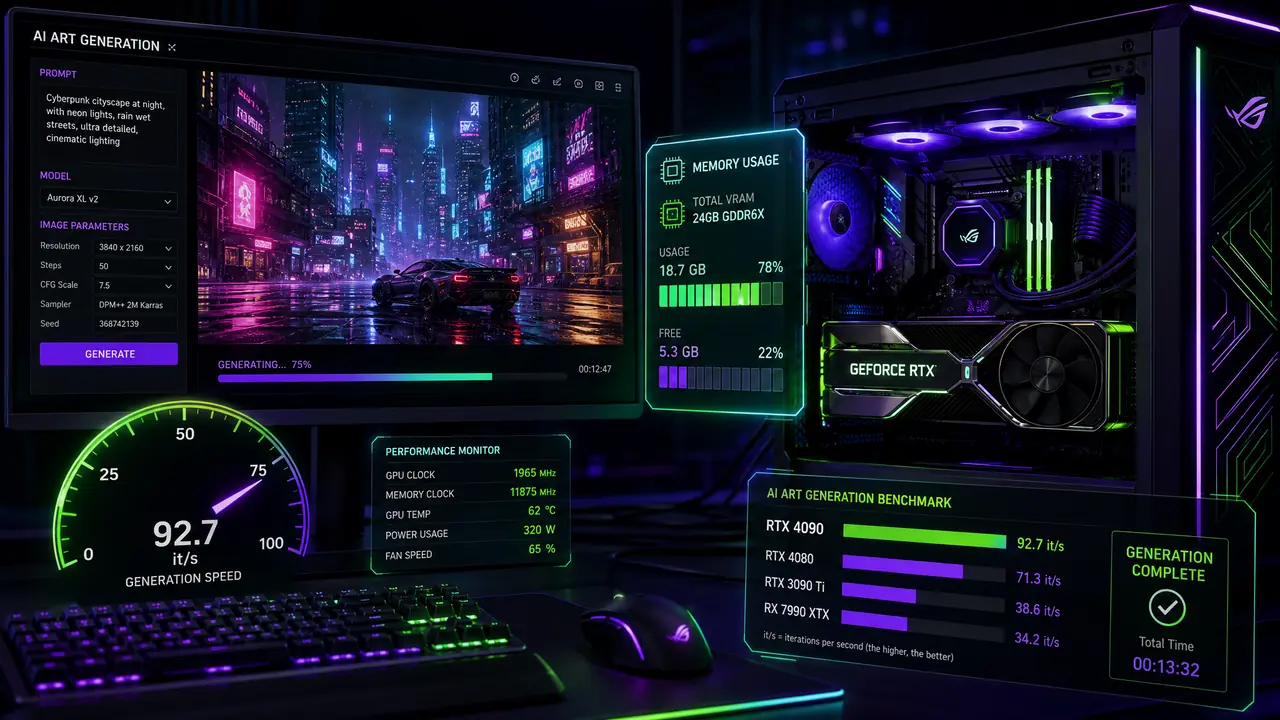
别绕了:4080跑ai绘画,1024分辨率10.8秒一张,显存8.6G,主流模型随便玩;真正的坎在2048大图和LoRA叠加上,16G显存会贴红线。9月底到10月中我记了一整套实测数据,速度、显存、电费三笔账全在正文,参数照抄就能跑。
4080跑ai绘画,我的答案是:够用,余量大到用不完。
先把测试环境交代清楚:RTX 4080 16G,i5-13600K,32G内存,Win11,SD WebUI(Forge版),模型以SDXL 1.0和几个社区大模型为主。卡是去年为打游戏配的,AI算顺带的。9月底装好环境抽了第一组测试图,当晚我就把云端平台的订阅停了。
之前一直用云端,排队排到第47位那种感觉,用过的人都懂。想拧个CFG都得重新排。搬到本地之后参数随便改,改废了重抽,成本忽略不计。下面这三笔账,是我拿一个月的截图和插排读数攒出来的。
出图速度:1024、1536、2048各要多少秒
4080跑SDXL,1024分辨率30步10.8秒一张,1536要23.6秒,2048贴着45秒走;换SD1.5只要4秒上下。测试条件先交代:DPM++ 2M Karras采样,CFG 7,fp16半精度,xformers开着,batch一次一张。
| 分辨率 | 20步 | 30步 | 40步 |
|---|---|---|---|
| 1024×1024 | 7.4秒 | 10.8秒 | 14.3秒 |
| 1536×1536 | 16.1秒 | 23.6秒 | 31.2秒 |
| 2048×2048 | 30.5秒 | 44.9秒 | 59.7秒 |
40步比30步多3.5秒,画质差距我瞪着屏幕对比了十来张,基本看不出区别。30步之后就是在烧时间。20步偶尔有细节没收敛,脸容易糊。所以我的默认档锁死30步,不纠结。
还有个省时间的野路子:batch拉到4。四张1024一起出,14.2秒全好,摊下来一张3.5秒,比单张快了三倍。显存会多占2G左右,1024这个档位完全扛得住。出头像、出表情包这种量大活粗的,我都这么干。
最舒服的是挂队列。睡前把60张构图小样丢进去,早上起来全是热乎的,一张没崩。这种一口气跑完的爽感,用过才知道。
显存占用:16G在哪个分辨率开始吃紧
显存这条线很清楚:1024吃8.6G,1536吃12.2G,2048顶到15.8G。16G的卡,前两档随便玩,2048贴红线,再叠东西就炸。
| 分辨率 | 采样阶段 | VAE解码峰值 | 16G能不能稳住 |
|---|---|---|---|
| 1024×1024 | 8.6G | 9.4G | 闭眼跑,还能叠LoRA |
| 1536×1536 | 12.2G | 13.5G | 稳,LoRA最多叠两个 |
| 2048×2048 | 15.1G | 15.8G | 贴红线,建议开tiled VAE |
这个峰值有个讲究,是我拿nvidia-smi盯了一晚上发现的:显存尖峰不在采样阶段,在VAE解码那一瞬间。2048的图采样全程15.1G稳稳的,一进解码直接蹦到15.8G,离16G就差一口气。哪天模型版本一变,或者后台多开个浏览器,就给你表演一个CUDA out of memory。
我就炸过这么一回。那天叠了两个SDXL LoRA去出2048,直接干爆,屏幕一串红字。LoRA单个只吃0.3G上下,两个加起来0.6、0.7G,在1024档位根本无感,到了2048就是压死骆驼的最后一根稻草。解法也简单:设置里把VAE切成tiled模式(切片解码),峰值能压回12G附近,代价是每张慢个两三秒。值。
xformers那个开关也提一嘴。关掉它,1024的显存从8.6G涨到11G出头,速度慢15%左右。现在没什么理由关它,默认开着就好。
本地和云端,哪边更划算
成本差着量级:本地1024一张电费约0.07分,云端普通档两三分、高清档两三毛。月出2000张,本地电费一块四。
| 口径 | 本地4080 | 云端平台 |
|---|---|---|
| 1024一张(30步) | 10.8秒,电费约0.07分 | 普通档2-3分,加速档0.2-0.3元 |
| 2048一张(30步) | 44.9秒,电费约0.3分 | 高清档0.3-0.5元 |
| 月出2000张 | 电费约1.4元 | 普通档40-60元,高清档大几百 |
| 排队 | 没有,队列随便挂 | 晚高峰常见几十位 |
电费是我拿功率计量插排实测的:出图时整机430瓦上下,按一度电5毛5算,1024那张10.8秒,折下来一张不到一厘钱。一千张连轴转,电费七毛。云端的价格我按去年充过的两个平台估的:普通档折算一张两三分钱,高清档和加速档能到两三毛,搞活动会便宜点,常态化就是这个价。
真把账算明白是在上个月。朋友开店,让我帮着出300张商品场景图。放云端加速档,粗算90块没了;本地跑了一晚上,电费五毛。他后来问我积分还要不要续,我说你这卡都买两年了,续什么续。
云端也不是一无是处。出门用笔记本,或者临时借别人的电脑,云端随手出几张确实方便;平台模型仓库上新也快,想尝鲜不用自己下十几个G的模型。但只要主力机里有张16G的卡,我真想不出再充积分的理由。
开篇那个问题,跑了一个月数据反而更笃定了:4080跑ai绘画,够用,余量还大。我的参数从9月底折腾到10月中基本定型,截图存了满满一个文件夹。书房里那台机器晚上还在嗡嗡转,这风扇声,比云端排队提示音好听多了。
常见问题
4070或者4060Ti也能照这个参数跑吗?
能跑,数字打个折。4070同样是12G显存,1024、1536照跑,速度大约打七折;4060Ti 8G版跑1024没问题,1536就得开VAE切片,2048基本告别。
为什么我同样的卡出图比你的慢?
大概率是三件事没对齐:xformers没开、误开了--medvram这类省显存模式(拿速度换显存)、采样器用了DDIM还配着50步。把这三样捋顺——xformers开、省显存模式关、DPM++ 2M Karras配30步——多数能追平我的数字。
SD1.5和SDXL在4080上差多少?
速度差三倍上下:512的SD1.5三十步3.9秒一张,显存4.2G。画质和提示词理解是SDXL明显好,我素材库现在九成换成了SDXL,SD1.5只留着跑几个旧风格LoRA。
一晚上连着出几百张,显卡顶得住吗?
顶得住。连续跑一晚上,核心温度60到80度是我的常态,风扇曲线调积极一点就行。真要挑毛病,是书房夏天像烤箱——冬天倒省了暖气。