AI绘画发展历程怎么看?从GAN到扩散模型的演进脉络梳理
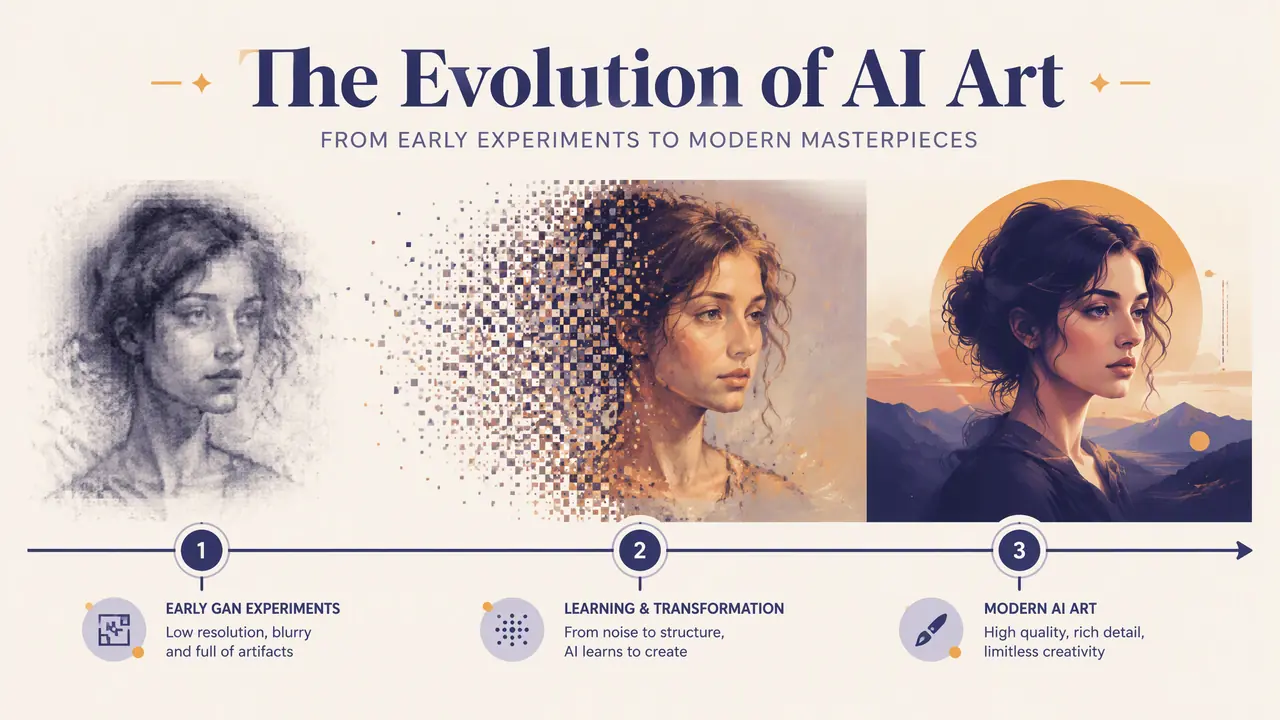
我的判断是:AI绘画这十年,真正的拐点只有三个——2014年GAN证明机器能画,2022年扩散模型把成本打下来,2023年之后的大战全在"听话"和"好看"上。记住这条主线,行业新闻就不用慌。每个节点怎么影响你今天出图,正文拆开讲。
看AI绘画历程的人,多半被这两年铺天盖地的工具更新搞晕了:今天这个模型刷榜,明天那个工具开源,追不动。我的建议是别追新闻,先记骨架——骨架稳了,新东西往哪个位置一放就懂。这篇文章给你骨架。
先自报一下观察位置。我从2023年初开始把这行当爱好折腾,从最早的免费工具一路用到今天,模型升级我基本都第一时间试过,手里存着一百多条自己攒的提示词和每次升级前后的对比图。下面的时间线,每个节点我都标了"当时的体感",那才是普通用户真正经历的历史。
三个拐点各自的分量
2014年GAN解决"能不能画",2022年扩散模型解决"画得好还便宜",2023年起行业的重心转向可控性和审美,三步各有各的意义。
把主线捋成一张表,你先看骨架。
| 节点 | 代表技术 | 解决了什么 |
|---|---|---|
| 2014年 | GAN(生成对抗网络) | 让机器第一次"画"出可辨认图像 |
| 2021-2022年 | CLIP对齐、扩散模型商用 | 文字驱动出图,质量跃升 |
| 2023-2026年 | 控制技术与大厂竞速 | 精细可控、风格成熟、门槛归零 |
展开说。GAN的思路是让两个网络互搏:一个画,一个挑刺,画的那方被逼着进步。它画的人脸often浮肿、眼睛歪,但在当年是石破天惊——机器第一次拿出了"创作物"。我后来翻资料看到那些早期的模糊人脸,感觉像看老照片,粗糙,可那是起点。
2022年是普通人感知最强的一年。扩散模型的工作方式是"先把图像打碎成噪点,再学会一步步还原",还原图像时套上文字条件的缰绳,就是你今天的文生图。那一年各家产品接连开放,我记得身边完全不懂技术的朋友都开始晒图了,这是2021年之前不可想象的场面。
2023年之后卷的是什么
画质不再是瓶颈后,行业比拼三件事:对手部文字等细节的修正、对构图的精细控制、对特定风格和主体的稳定复现。
2023年我印象最深的是"手"的翻身仗。前一年画手十张九崩,年中各家模型针对性补课后,五指问题基本收敛。同年我第一次用"局部重绘"功能改掉一只崩手,那种感觉像P图软件进入了三维时代——你指定区域,模型只动那块。细节修复、扩图、姿态控制这些能力,都是这个阶段陆续补齐的。
2024到2025年,玩法往两个方向走。一头是控制精度:姿势骨架、参考图、多层编辑,出图从"抽卡"变"施工"。另一头是审美内卷:模型默认出图越来越"懂构图",我2026年10月随手出的一张图,光影摆位比我自己三年前写的提示词还讲究。卷到最后受益的是用户,你说的越少,它补的越多。
普通用户视角的四个体感变化
出图从分钟级到秒级、从英文特权到中文平权、从抽卡到施工、从单图到工作流,四个变化对应四个阶段。体感比参数诚实。
第一,速度。2022年我出一张图要等一两分钟,现在十秒上下,快了十倍不止。第二,语言。2022年不会英文提示词寸步难行,现在中文直接写,理解偏差很小。第三,掌控。早期靠运气抽卡,现在垫图、控姿态、改局部,顺序基本按你的施工图来。第四,链条。从"画一张图"变成"画一套图、接一段视频、配一段文案",AI绘画成了内容生产线的一环,不再是孤立的玩具。
四条变化带来的后果是:把"会不会画画"这个门槛挪掉了,但把"想清楚要什么"的门槛抬起来了。工具越是听话,描述能力越是稀缺。这也是我常对新手说的:别囤工具清单,练描述。
往前看的话,我觉得下一个值得盯的点在"一致性"——同一个角色跨图跨视频不变形,这块一旦做实,普通人做动画短片就是拧开水龙头的事。时间点我说不准,方向大概率是这。
拉回开头那句主线:三个拐点,一条从"能画"到"画好"再到"听话"的路。你手里的每一次出图,背后都是这条时间线的堆积。下次再看到"某模型刷新纪录"的新闻,先别激动,问问它在三个拐点坐标系里挪了哪一格——多数新闻答不上来,能答上来的才值得你花一个晚上试。
常见问题
GAN和扩散模型有什么区别?
GAN靠两个网络对抗学会画画,扩散模型靠"打碎再还原"的思路学去噪。后者训练更稳、质量上限更高,所以成了如今的主流路线。
为什么2022年被认为是爆发年?
那年扩散模型商用产品密集开放,文字生图的成本降到普通人零门槛,出图量级和参与者规模都是断崖式跳涨。
现在入坑AI绘画晚吗?
不晚。工具门槛已降到历史最低,缺的只是描述能力和审美训练,这两样什么时候开始练都不迟。
下一个技术拐点可能是什么?
角色一致性、长视频生成、更精细的编辑控制都是热门方向,落到生活里就是普通人也能稳定产出成套的内容资产。