多人绘画AI同框出图:站位脸崩融合差的实战修法
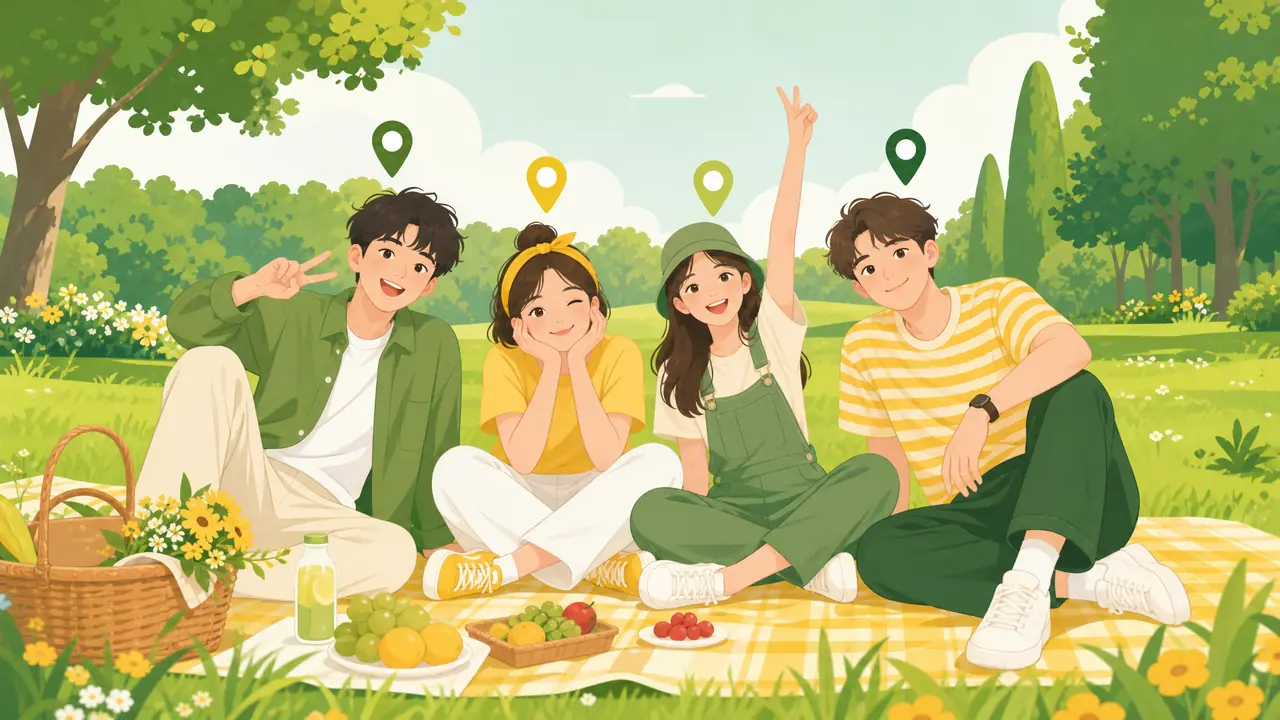
先给判断:多人绘画AI出图,人数越多越要"给角色发剧本"——每个人物单独一段描述,站位、动作、服装分着写。一句"一群朋友聚会"丢给模型,它必给你拼出三张脸的融合怪。文内两套底稿加一个改稿顺序,10月实测把四人图可用率从两成拉到七成。
多人绘画AI这个需求,一到四人以上就开始见真章。单人图模型闭着眼画,双人图开始抽卡,四人往上,脸融合、手搭肩搭到别人脖子上、说好四个人出来六个,全是常态。
上个月同学会,班长要做一张聚会海报,图上得有代表性的人数感。我把这段时间攒的多人物方法全拿出来跑了一遍,废了四十多张,总结出的问题基本逃不出三类:脸拼了、手错了、数不对。这篇就按这三类往下拆。
先说清一个预期,免得你按错标准要求自己。多人图和单人图的"稳"不是一个概念:单人图稳是九成可用,四人图能到七成就已经算掌握了,剩下的三四成靠抽和修。追求百分之百再学工具也不划算,把可控的先攥在手里。
脸融合的根源与人数词的写法
脸融合是模型把相邻人物的五官特征平均化导致的,人数词越模糊越严重。人数必须写精确数字,每个人物另起一句独立描述,模型才不会"平均"他们。
你写"两个女孩",模型理解的是"一个两人份的女孩",五官是从训练集里平均出来的。正确写法是分开点名:左侧短发女孩穿黄色卫衣,右侧长发女孩穿白色连衣裙。位置词(左、右)是关键,它给了模型分区处理的锚点。
人数词同样要精确。"几位朋友""一群人"都是雷,模型自由发挥起来三到八人不等。写"四个年轻人",配合站位词"两前两后",数量基本能锁住。我的记录里,精确数字加站位词的组合,人数出错率从约四成降到一成出头。
对了,超过六人就不建议纯提示词硬控了。那是区域控制或局部重绘的活,提示词写到那个人数,稳定性和抽卡没区别,别耗在那儿。
为什么脸会"平均",多说一句我的理解。模型没有"个体"概念,它眼里的画面是一整块像素,你不起锚点,它就把所有"女孩"的描述叠在同一块区域里调和。位置词、人物数量、独立特征句,本质都是在帮模型画分区线。锚点越多,脸越独立。这个思路想通后,我后来画双人图几乎没再翻过车。
站位描述顺序与两套底稿
站位要按"从左到右、从前到后"的阅读顺序写,一次只交代一人的位置加动作加服装。顺序乱了模型就会把特征安错人头。底稿照这个结构抄。
双人闺蜜照底稿:咖啡馆窗边,左侧短卷发女生穿姜黄色毛衣捧着马克杯微笑,右侧长直发女生穿米色风衣侧头和她说话,两人隔小圆桌对坐,午后阳光。四人聚会海报底稿:户外草坪聚会,前排左侧女生举着饮料、前排右侧男生蹲姿比剪刀手,后排左侧男生抱着吉他、后排右侧女生扎马尾挥手,从左到右依次描述。
描述顺序这个事,我是吃过亏才服气的。有一版我把后排男生的"抱吉他"写在了前排女生前面,出图吉他挂在了女生身上,姿势别扭得像借道具拍证件照。从左到右、从前到后,严格执行,特征安错位的情况基本绝迹。
服装颜色也顺手提一下。多人物图里,每个人的主色拉开色相——黄、白、蓝、绿各占一个——模型区分人头的成功率明显高。全员同色系的图,脸融合率直线上升,大概因为特征本来就少,颜色再糊在一起,模型更懒得分区了。班会海报那版我特意安排了四色,确实稳。
| 人数 | 可控方式 | 可用率(我的10月记录) |
|---|---|---|
| 2人 | 纯提示词点名 | 约八成 |
| 4人 | 提示词加站位词 | 约七成 |
| 6人以上 | 建议上区域控制 | 提示词硬控不足三成 |
多人合照的修图思路另有一套,合照修图AI:多人照片的修图方案和避坑指南是拿真实照片动手的,和这篇的生成路线正好一头一尾。
海报最后交出去那天,班长把图发在群里,底下有人问找谁拍的。四个人物站得松散自然,每个人的脸都清清爽爽。我没说这张图废了四十多个前身——出图快了,挑图的耐心反而成了新的稀缺品。
常见问题
多人绘画AI出图人物手部总是崩怎么办?
减少手部交互描述,把"手搭肩"改成"并肩站立",出图后单独圈选手部做局部重绘。交互动作越多,手崩得越快,先站好再互动。
为什么写死了人数还是多出来人?
检查提示词里是不是有复数名词残留,比如"路边人群""围观者"这类词会追加人数。全部换成精确数字,背景人物写"虚化的行人"并压低权重。
双人头像用什么构图最稳?
对称双半身或者一左一右的肩上特写最稳,避免叠脸构图。两人面部距离越近,融合概率越高,中间留一个物件隔开更好。
多人图适合用什么分辨率出?
横幅1024x1024起,人物超过三个建议1344x768横构图,给每个人物的脸留够像素。小分辨率多人图,脸崩是从像素不够开始的。