换装按钮背后,AI模特到底在干什么:换装技术白话拆解
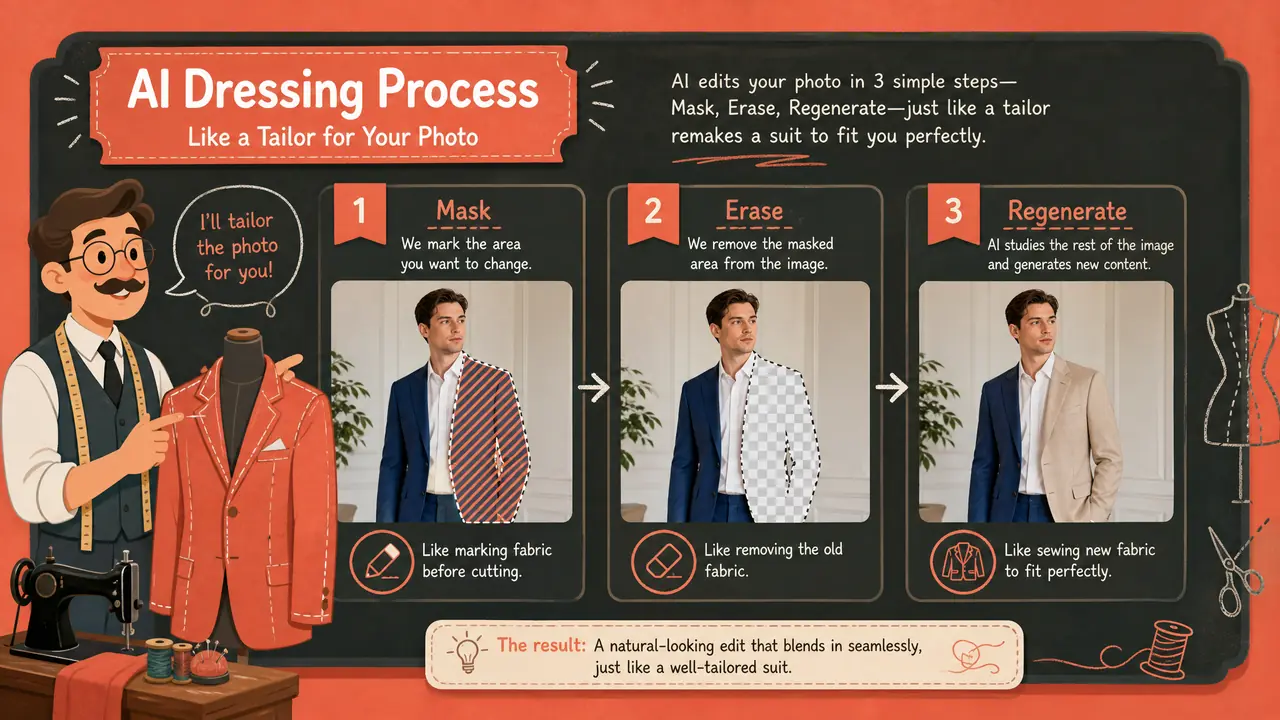
ai模特换装技术没什么魔法,把黑话翻译一下就是三步:画蒙版、擦旧衣、照着参考图长新衣。看懂这三步,出图翻车你就知道该调哪里,不用再靠玄学狂点重抽。
ai模特换装技术拆开看不神秘:先用蒙版认出哪是衣服,把旧衣服擦成一片噪声,再照着新衣服的样子把内容重新"长"回去。我一直把它想象成一位修照片的师傅在接活——师傅不重画整张照片,只动衣服那一块。下面就按这三步,把后台的活儿一件件说给你听。
换装按钮背后,AI在干哪三件事
换装就是三步活儿:先用蒙版圈出衣服在哪,再把这块区域擦成噪声,最后照着参考图从噪声里长出新衣服,整张图不用重画。听着像修图师傅的三道工序,其实一行行对应着三种模型的分工。
很多卖家的理解停留在"AI把衣服换了",中间过程是个黑盒。打开这个盒子,里面站着三个角色:一个负责"看",认出衣服的边界;一个负责"擦",把旧衣服区域搅成一团雪花点;一个负责"长",照着你给的参考图,从雪花点里一点点显影出新衣服。术语分别叫分割、扩散、参考图引导,你不用记,记住师傅、抹布和样品就够了。
这三步里,哪一步最容易出岔子?我毛估了一下手头跑过的案例:蒙版环节的错占一半上下,扩散生成占三四成,参考图引导占剩下的一成多。也就是说,图烂了先怀疑蒙版,十次里有五次是它。这张表可以存下来对着排查。
| 环节 | 白话理解 | 典型毛病 | 毛估出错占比 |
|---|---|---|---|
| 分割画蒙版 | 认出哪是衣服哪是人 | 边缘不齐,擦多了或擦漏了 | 五成上下 |
| 扩散生成 | 从噪声里显影新内容 | 纹理脏、褶皱乱、布料质感怪 | 三四成 |
| 参考图引导 | 照着样品的样子长 | 款式像了但细节走样 | 一成多 |
顺带说一句,这张占比只是我自己的观察,不同工具、不同类目的衣服会有出入,但量级不会差太远。
第一步画蒙版:先告诉AI哪是衣服哪是人
蒙版就是给AI圈重点:模型先认出哪是衣服哪是皮肤,再用一张遮罩标出只许动的范围。领口老出错,多半是遮罩边缘没画齐。这一步对应术语里的"图像分割"。
师傅翻新一件衣服前,会先用胶带和报纸把墙面、窗户都盖住,只露出衣服那块。蒙版干的就是这个活:一张黑白图,白色区域是"可以动",黑色区域是"碰都不许碰"。分割模型先扫一遍原图,把衣服、皮肤、头发、背景各自圈出来,然后生成这张遮罩。
领口和袖口的细节为什么老出错?根源就在遮罩的边缘。衣服和皮肤交界的地方,边界线弯弯绕绕,模型稍微判偏一点——比如领口那圈花边被划进了"可以动"的区域——后面擦除和生成就都会波及它。新长出来的布料在领口位置对不上旧图的茬,于是多出一截布条、走线歪掉,或者领型悄悄换了。你以为AI手潮,其实是第一刀的圈没画准。
我踩过一回这样的坑:一条连衣裙的腰带扣总被重画成另一副样子,反复改提示词毫无用处,后来把腰带从蒙版里抠出去,一次就稳了。那次之后我养成了习惯,翻车先看蒙版。
第二、三步擦掉再长回:扩散模型与垫图的作用
扩散模型像冲印照片:先把旧衣区域打成雪花噪点,再照参考图一步步显影,新衣服就从噪声里长出来。垫图等于给师傅看实物样品。擦和长,其实是同一个模型的两头。
先把"擦掉"说清楚。扩散模型学的是"怎么把一张清晰的图一步步变成雪花噪点",学会之后倒过来放,就是"怎么从一团噪点里一步步还原出清晰内容"。换装时,程序把蒙版圈住的旧衣服区域打成噪声,再让模型照着提示词和参考图,一步步把这片噪声"显影"成新衣服。你在电视雪花屏里隐约看出一张脸,再慢慢变清晰——大致就是那个过程的逆放。
"长回去"这一步,靠的是参考图引导。只给文字提示词,相当于你在电话里跟师傅形容"一件米白色针织开衫,圆领,袖口有罗纹",师傅凭经验做,像个大概,细节全靠猜。垫一张清晰的新衣服图,等于把实物样品拍在案头上:领型照这个、印花照这个、罗纹密度也照这个。所以垫图的质量直接决定成衣的还原度——样品图糊了,师傅也只能照着糊的样子做。
跑题说一句,很多人以为垫图越多越好,其实给三张互相矛盾的样品,师傅反而不知道照哪张做。一张清晰的主图,往往比五张角度乱的图强。拉回来接着说。
懂原理有什么用:知道该动蒙版还是动提示词
出问题别急着改提示词:领口袖口烂了先动蒙版,款式不像先补参考图,颜色材质不对才轮到提示词。排查顺序对了,效率翻倍。这是原理能兑换的最实在的好处。
不懂原理的排查方式是重抽,抽到好看为止,一晚上可能烧掉几十张额度。懂原理的排查是分诊:领口烂、袖口歪、腰带被吃掉,指向蒙版,去收紧遮罩范围;款式不对、印花走样,指向参考图,换更清晰的垫图或者加权重;只有颜色脏、材质怪这种全局问题,才轮到改提示词或者调生成强度。三个科室各管各的病。
按我自己的记录毛估,分诊式排查平均两三张就能定位问题,瞎抽式平均要七八张,效率差了一倍多,额度也省下来了。这笔账对每天出几百张图的卖家来说,一个月差出的是实打实的成本。
把三步收拢成一句话:蒙版决定AI在哪里动工,扩散决定它怎么从噪声里造出布料,参考图决定造出来的样子照谁抄。下次点那个换装按钮,你脑子里能浮现出师傅擦掉旧衣、摆好样品、慢慢显影的画面,就已经超过大多数只会在旁边狂点鼠标的人了。
常见问题
换出来的图连脸也变了,是哪一步出了错?
多半是蒙版范围过大,把脖子、下巴的边缘也圈进了"可以动"的区域,生成时连带重画了皮肤。把遮罩往下收紧,只留衣服本体,脸部一般就稳住了。
垫了同一张图,每次出来的细节还是不一样?
正常。扩散模型从随机噪声起步,参考图管款式走向,管不到每一根走线。想稳住细节,可以降低生成强度、固定种子,或者对不满意的位置做局部重绘,别指望整图每次都一模一样。
不垫图、只写提示词,能做出一模一样的衣服吗?
做不到。文字只能描述"米白色开衫"这个级别的特征,logo、印花图案、特殊领型这些精确细节,文字传不到位。想还原一件具体的衣服,垫图是绕不开的。
蒙版和提示词,到底先调哪个?
先看毛病出在哪:边缘烂、范围错,动蒙版;款式不像、细节走样,动参考图;颜色、材质、氛围不对,才动提示词。先动蒙版再动提示词,顺序反了会白折腾。