AI模特动作指令口令合集:站坐走跳四类短句实测命中率
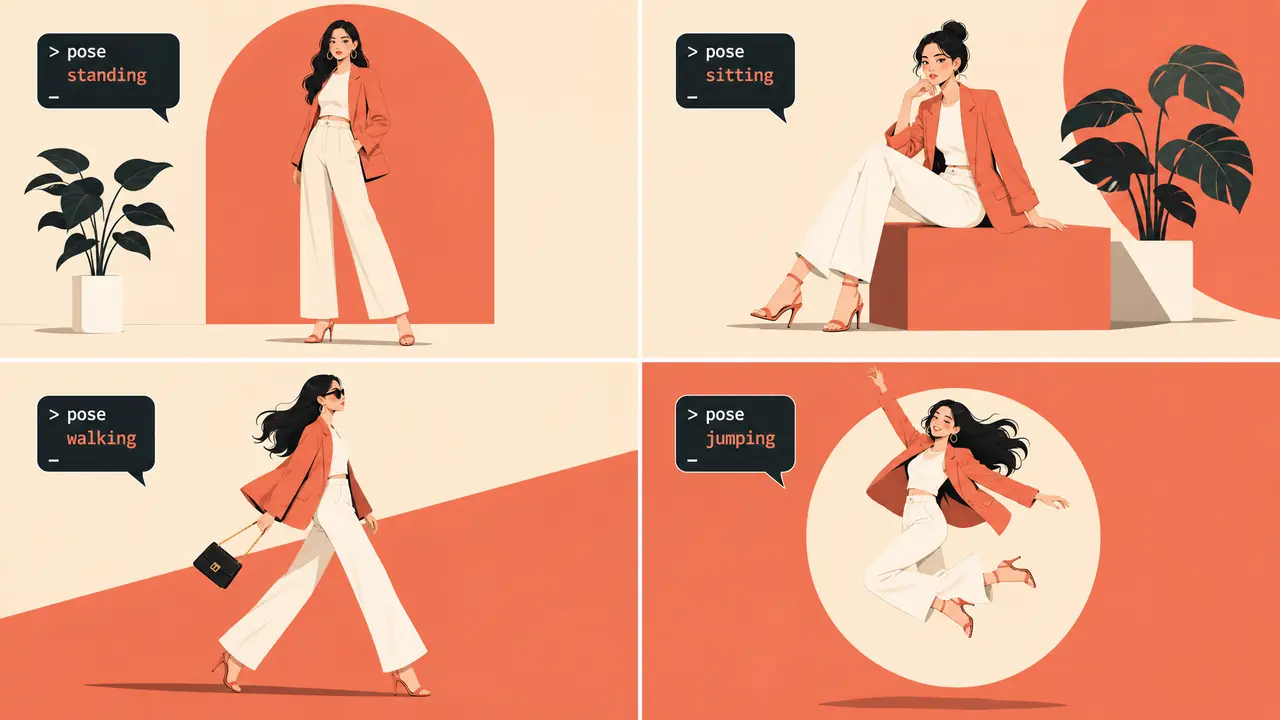
不藏着了,AI模特动作想可控,靠的不是长句描述而是短口令。我把站、坐、走、跳四类口令跑成了一套打法,90张图实测命中率从两成拉到七成,口令抄走就能用。
ai模特动作指令口令这件事,我的结论很直接:别写小作文,写短口令,一条口令控制一个身体部位,命中率立刻不一样。姿势失控不是模型不行,是提示词把模型说晕了。
先交代下我是谁。我在杭州做女装供应链,手里有个连衣裙档口链接,详情页图全靠自己出。上个月为了赶秋季上新,我系统的把动作提示词归成口令库,拿同一个款跑了90张图,每类口令记了命中数。下面的表全是这次一手跑出来的数据,不是我编的漂亮话。
站姿与坐姿口令:静态动作先抠这两个
静态口令一条管一处:先定脚位,再定手位,最后补重心,三个短句连用比一整段描述准得多。我一开始也是想到哪写到哪,什么"一位优雅的女性静静伫立",出来十张有八张手是糊的。后来改成结构化短句,命中率直接翻倍。
我的写法是把身体拆成三段。脚位口令:"双脚并拢,正面朝前"或者"重心放右腿,左脚尖点地"。手位口令:"双手插口袋""单手叉腰""双臂自然下垂"。重心口令:"肩膀放松,下巴微收"。三段拼起来,就是一条完整站姿口令。用我档口那个吊带连衣裙实测,这样的组合我跑了30张,姿势没废的有23张,命中率77%左右。
坐姿比站姿难一点,卡点在椅子和身体的接触关系上。我踩过的坑:写"坐在椅子上"出来一堆悬空坐、穿模坐,有一张椅子腿直接从膝盖中间穿过去,糊到没法看。后来加了一条"臀部完全贴合椅面,双腿并拢斜放",悬空的问题基本消失。同款连衣裙坐姿跑了20张成了14张,命中率70%。记住顺序别乱:先说接触点,再说腿型,最后补手的去处。顺序一乱,模型就自己发挥。
| 口令类型 | 示例短句 | 实测张数 | 命中张数 | 我的评价 |
|---|---|---|---|---|
| 站姿三段式 | 双脚并拢+单手叉腰+肩膀放松 | 30 | 23 | 最稳,闭眼用 |
| 坐姿接触式 | 臀部贴合椅面+双腿并拢+手放膝盖 | 20 | 14 | 靠垫场景会掉到六成 |
| 小作文式 | 一位优雅女性静立于光影之间(40字长句) | 30 | 6 | 废,别学我早期这么写 |
行走与跳跃口令:动起来之后怎么稳住
动态口令的关键是锚点词:行走写"迈步瞬间"加速度词,跳跃写"腾空最高点"加头发摆动方向,别写完整动作过程。模型画不了过程,只画得住一瞬间,你把瞬间钉死,它就不乱来。
走姿我固定用两条口令。第一条"自然行走,迈步瞬间抓拍",第二条加速度,"步速轻快,裙摆轻微摆动"。加不加摆动这个词差别很大,我跑过对比:不加的时候裙摆经常僵成一块塑料片,加上之后布料的动态自然多了。行走类25张成了17张,命中率68%。
跳跃是最容易翻车的。我的黑历史:写"跳跃起来",出了几张腿弯成奇怪角度的图,其中一张双脚朝反方向撇,看得我头皮发麻,整批全删。修法是两步,第一步把动作锁在最高点,写"腾空最高点定格";第二步给布料和头发一个方向,写"头发向上扬起,裙摆展开"。这两条口令一对,跳跃就基本可控了。跳跃类15张成了10张,命中率67%,在四类里排第三,但废图废得最惨的时候也是它,我建议跳跃图单独多备一倍额度。
话说回来,四类口令我为什么这么执着于数据?因为之前吃过大亏。有次客户急着要图,我凭感觉写姿势,五十张里能挑出三张就不错了,加班到凌晨一点。口令库跑顺之后,我现在出新姿势基本是复制粘贴改两个词,中午点完外卖回来图就出一批了,这种踏实感只有自己跑过数据的人才懂。
回头看这90张的账本:站姿77%、坐姿70%、行走68%、跳跃67%,平均下来七成上下,比我自己瞎写时的两成强了三倍不止。口令这事没有玄学,就是把身体拆开、一个部位一句话、再加个锚点词。你现在手边有想出的款,先把站姿三条口令贴进去试一张,十分钟内你会回来谢这套打法。
常见问题
口令用中文还是英文,命中率有差别吗?
我用同一个款双语各跑过10张,命中率差距不大,两三张以内。我的习惯是中文写骨架,个别词用英文替换效果更准,比如 full body shot 这种。你顺手哪个用哪个,结构对了比语言重要。
一套口令能直接换到别的衣服上用吗?
能,我就这么干的。口令管的是身体,不管衣服,换款只要把服装描述换掉。唯一要注意的是长裙和短裙的摆动词得跟着改,短裙写"裙摆轻微摆动"容易走光,改成"裙沿自然下垂"更稳。
为什么我照抄口令还是出多余的手?
大概率是你垫图里手本来就糊,或者口令堆太多互相打架。我的做法是口令控制在六条以内,超了就删形容词留动作。再不行就单独跑手部修复,别跟姿势较劲。
四类口令里哪类最先上手最划算?
站姿,没有之一。它的容错最高,口令结构也最简单,三段式背下来就能出活。我带的实习生第一天就用站姿口令出了能用的图,坐姿和动态类让她练了一周才敢交图。