怎么指令ai生成模特?说人话的一句话指令教程
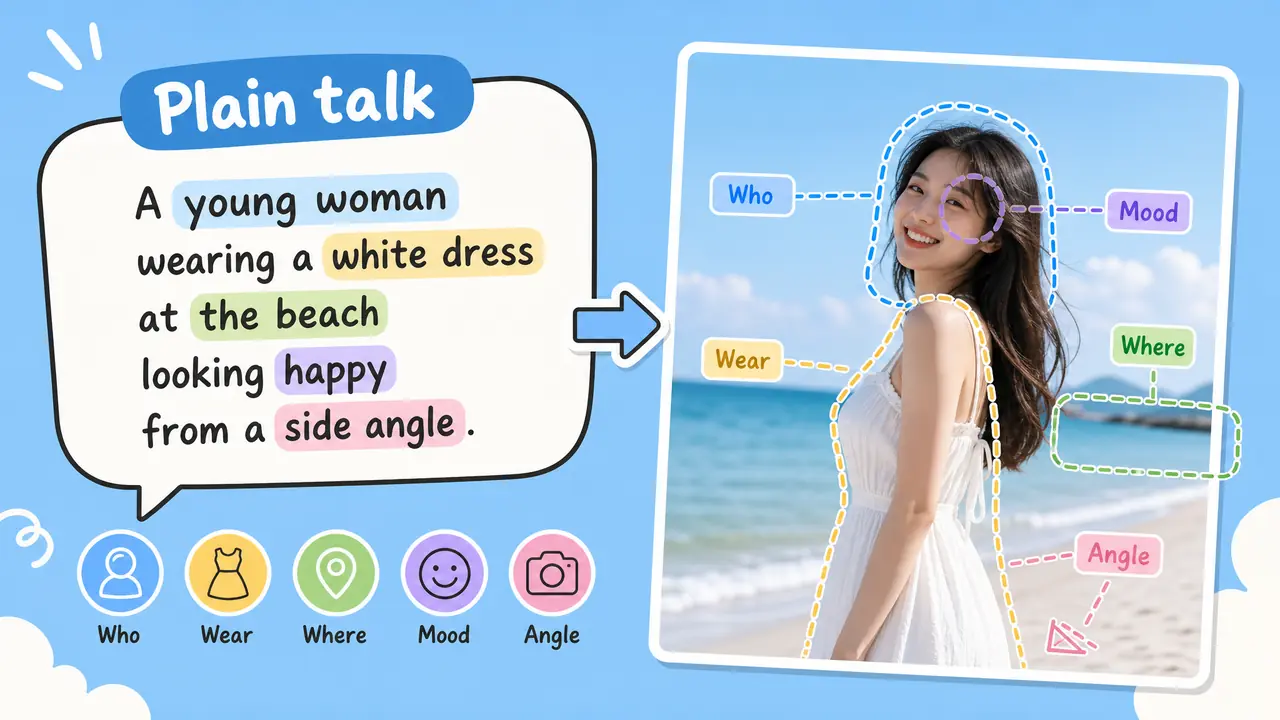
开门见山:指令ai生成模特,用不着背任何参数词,把一句大白话说完整就行。五要素——谁、穿什么、在哪、什么感觉、什么角度——说齐了,第一张图十次里能过七次;说不齐,就分轮追问着改。这篇把说话公式、追加指令的规矩、翻车案例和口语跟专业词的对照一次讲完,零基础看完能开口要图。
前天晚上十点多,一个卖围巾的宝妈在群里@我,发了张歪脖子模特图,问我是不是得先背完那套两百词的"咒语表"才能出正常的图。我看了她原来的指令:"生成一个戴围巾的模特,好看一点,高级感,电影感,ins风,氛围感拉满,再加雪景。"我让她改成一句大白话:"一个三十岁上下的女生,围着图里这条驼色围巾,站在下过雪的街上,光线柔一点,拍半身。"四十秒后新图出来,她回了俩字:卧槽。
这样的对话,从2026年3月我拉第一个新手群到现在,复现过不下一百次。群里学出图的人我记了名册,一百三十七个,最后都靠同一件事开窍——把指令当说话,别当咒语。说白了,ai就是个听话但死板的实习生:你跟同事怎么交代需求,就跟它怎么说。你要是甩给它一堆形容词,它就只能挑着听。
一句话公式:五要素说齐,图就歪不到哪去
人话指令的公式就五个要素:谁,穿什么,在哪,什么感觉,什么角度。一句口令里五样占齐,出图基本歪不到哪去。少一两样,图就开始自由发挥。
逐个拆开讲。"谁",说年龄段、性别、气质就行,"二十五岁左右的女生"比"一个美女"管用十倍。"穿什么",颜色加款式,要展示自家货就得传参考图,口令里补一句"穿图里这件"。"在哪",给个具体地方,"下过雪的街道"或者"原木色的桌面旁边",别只写"户外"。"什么感觉",说光,"光线柔和"和"傍晚暖光"都行。"什么角度",全身、半身还是特写,一句话钉死。
这五样不是平起平坐的。我翻过群里出废图的记录,前两个要素(谁、穿什么)缺一样,图直接作废;后三样缺一样,图只是平,还能救。对了,被新手忽略得最狠的是"什么感觉"——十张灰蒙蒙的废图里,七八张是因为压根没说光线。
一条合格的完整指令长这样:"一个二十五岁左右的女生,穿图里这件白色羽绒服,站在落雪的街道上,傍晚暖光,拍全身。"念出来就是一句人话,二十来秒说完。
不满意别重开,指哪改哪
图不满意就在同一轮对话里接着说:哪里不对指哪里,一次只改一处,改对了再说下一处。动不动推倒重来,是大忌。
追加指令有三条规矩。第一,别说"重来",要说"背景和人物都别动,只把拉链拉高一点"——你圈得越死,它越不敢乱动。第二,一轮只提一个改动,两个封顶。第三,连改三轮还不对劲,别续了,说明第一句就没说好,重发第一句另起一轮。
举个真实改法。一个做童装的学员,第一轮出的图帽子影子盖住了小孩半张脸。她的第一反应是全盘重出,连出五张,张张影子位置不同。我让她只发一句:"人和背景都保留,光抬高一点,别让帽子在脸上投影子。"一张过。改图的顺序感很重要:先锁住不动的部分,再点要动的部分,这个顺序反了,ai会把整张图重画一遍。
还有个坑得提醒:改到三轮以后会"漂移"。你改帽子,领口悄悄变了;你改手,背景的灯又换了。每追加一轮,前面改好的地方都可能松动。所以我的习惯是三轮为限,超了就带着已确定的要求重新发一遍第一句。操作上还不熟的话,对话框、传图、连续改图这些步骤,我之前写过一篇豆包ai模特教程:零基础店员学会出图的完整流程,照着点就行,这篇不重复。
实测可用率,和一个塞了九个要求的翻车案例
五要素说齐的指令,二十张里十四张可用;一口气塞八九个要求的,二十张只过六张,ai基本只执行前两个。这是2026年10月最后一周的实测账。
做法交代清楚:我从群答疑里挑了出镜最多的三种商品图——羽绒服、针织开衫、白衬衫,同一批图用两种指令方式各出二十张。"可用"的标准是不修图、能直接发预览群。结果一边倒:五要素组十四张能直接用;堆要求组只过了六张。我又把堆要求组一张张对着数了执行情况,二十张图里ai平均只落实前两个要求,第三个开始执行率断崖往下掉。
翻车案例印象最深的是卖冲锋衣的小周。她第一句是这么写的:"加雪景,换黑配色,加绒帽,改竖版,留出文案位置,模特笑一点,戴手套,黄昏光线,再加点倒影。"九个要求一句话。出来的图只换了雪景,配色、帽子、竖版全没动。她不信邪,重发了三遍,越改越乱——第三轮的时候,原本已经换好的雪景又没了。后来我让她拆成五轮,每轮最多两个要求,二十分钟出齐了四张能用的。图是能出,就是不能贪。
把群里最常问的几类要求整理成对照表,左列是新手在对话框里打的原话,右列是同类要求在专业工具里的写法,顺便标了听话程度:
| 群里的原话 | 专业词写法 | 听话程度 |
|---|---|---|
| 光柔一点,别太白 | 柔光布光,低对比,色温5200K | 人话版更稳 |
| 离远点,拍全身,脚下别裁 | 全景构图,全身入镜,脚部留白 | 基本能懂 |
| 背景虚一点,突出人 | 大光圈浅景深,f/2.0 | 人话版够用 |
| 下午四点太阳那种感觉 | 暖调侧光,低角度光位 | 两边各有各的歪法 |
| 平视拍,别仰着拍 | 平视机位,50mm焦段 | 人话版更稳 |
说实话,右列那些词对零基础的人是负担。聊天式出图的工具吃人话,你跟它讲行话,它一知半解地执行,一半靠猜。等专业工具的那套参数你真用上了,人话公式照样是底稿——先说清楚要什么,再谈精度。
回到那个围巾宝妈。她现在每晚出五六张预览图发粉丝群,用的还是那套笨办法:一句话说全五件事,不对就指着改,一次改一处。出图这件事,门槛早就不在工具里了,在嘴上——你把话说完整,ai比你想象的听话。
常见问题
纯打字不传图,能指令ai生成模特吗?
能出图,但衣服是ai自己想的,跟你家货对不上。要展示自家商品必须传参考图,口令里加一句"穿图里这件"。纯文字出图适合还没定款、只想先看风格的阶段。
这套说话方法换个工具还管用吗?
管用。豆包、即梦这类在对话框里出图的工具都吃这套人话。Midjourney那种命令行工具是另一套写法,参数词该写还得写,五要素公式只适用对话式工具。
一句话里最多能塞几个要求?
两个。我数过堆要求组的二十张图,ai平均只落实前两个,第三个开始执行率掉得很快。想加要求,分轮说,一轮说一个。
想固定同一张模特脸,指令怎么下?
先出一张你满意的脸,之后每次都把这张图当参考传上去,口令里写明"模特长相跟图里保持一致"。十次里能稳住六七次。纯靠嘴描述长相固定不住,别费这个劲。
生成的图能直接当电商主图用吗?
不建议。手指、拉链、Logo这些细节翻车率高,主图是要被买家放大检查的。当预览图、内部选款图放心用,上架图请走专业流程。