ai模特软件出动态视频,上限在首帧:图生视频模特的首帧策略实测
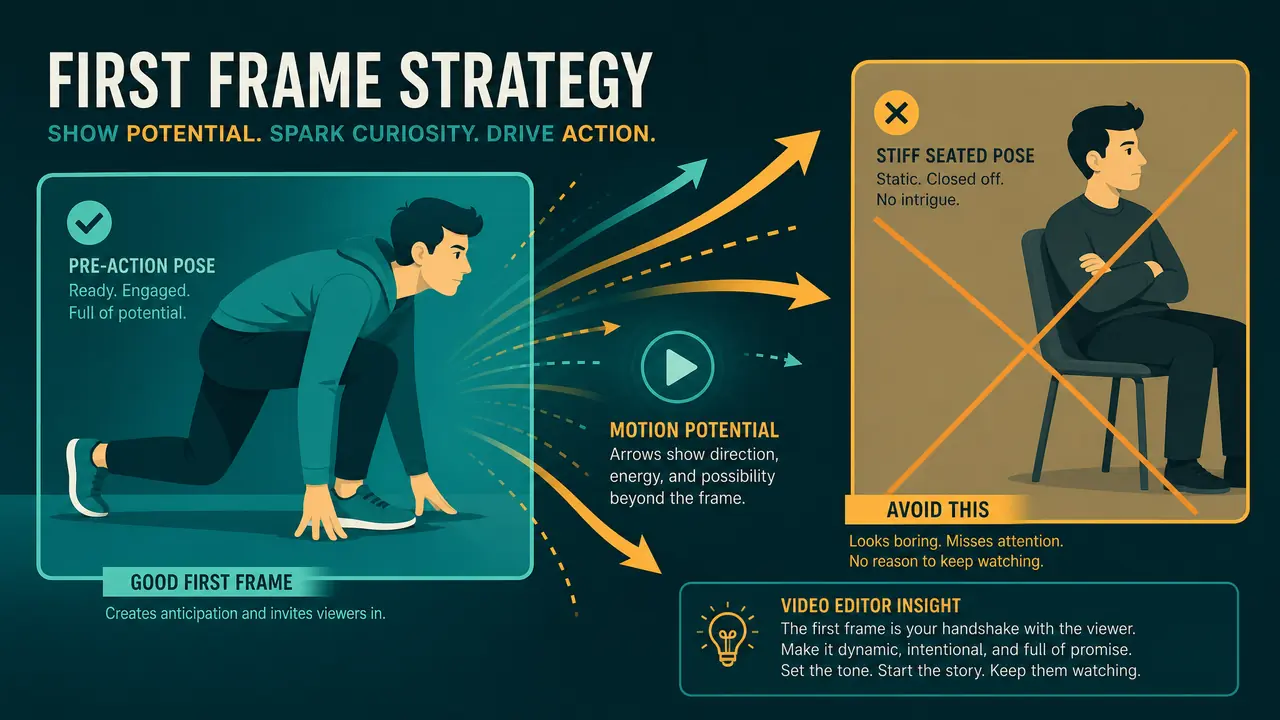
视频老手说:做了几百条图生视频之后,我只剩一个结论——视频的上限在首帧。首帧是照片,尾帧才是视频质量,你喂给模型什么样的照片,它就还你什么样的动态。
这篇把首帧策略拆成姿势幅度、可动区域、构图余量三层,配上我的自测数据和一次印象很深的翻车,讲透「为动而拍」这件事。
ai模特软件动态出片,上限在首帧:模型拿到你的照片,做的不是凭空创作,是顺着照片往下演。首帧是定场照,也是剧本本身。我翻了三百多条图生视频的生成记录,又做了轮只换首帧的对比测试,结论比想象里还极端——首帧不行,后面全白搭。
这篇讲首帧策略:它凭什么决定上限,拆成哪三层,怎么在出图那一步就把视频的事提前想好。
首帧决定论:首帧是照片,尾帧才是视频质量
图生视频是围绕首帧做延续,模型把首帧当成不可推翻的事实,后面每一帧都是对这张照片的演绎,首帧的毛病只会被放大,不会被修正。所以同一套提示词,换首帧就是换命运。
很多人把图生视频理解成「模型自己会演」,其实更像给面团定型:首帧什么形状,后面的动作全从这团面里长出来。照片糊的地方,它默认你想要糊;姿势僵的地方,它默认你想要僵。
我做过一轮只换首帧的专项测试:同一个模特、同一套动作提示词,一共80条。首帧清晰、姿势留了发力空间的那组,十条里约莫八条能用;另一组十条能挑出三条就算烧高香。这个差距不是提示词能填平的:把「自然起身」改成「缓缓站起」,一个字的效果都没有。
第一层:首帧的姿势幅度,就是动作幅度的天花板
首帧的姿势幅度就是动作幅度的天花板:张开的姿势动不起来,收到一半的预备姿势才动得起来。首帧摆得越满,模型越不敢动它。想让模特动,先让她蓄而未发。
这层最好懂,也最反直觉:一张双臂完全张开、裙摆甩到满幅的图,看着很有活力,偏偏最难驱动。模型面对一张已经张满的姿势,只有两个选择:维持,或者往回收。往回收像倒放,维持又没意思,它干脆只让手指和头发意思一下,成片就成了「会眨眼的照片」。
反过来,重心压在前脚、手臂收到七分、像下一秒就要迈出去的预备姿势,成功率完全不是一个量级。还是那80条测试:张开姿势组24条成了7条,预备姿势组56条成了47条。姿势收到五成,动作才有从零到一的起跳空间——跟跳水先蹲是一个道理,蹲得下去才弹得起来。
第二层和第三层:可动区域与构图余量
首帧里糊掉的部位,视频里只会更糊;首帧里顶满画面的模特,抬手就出画。可动区域管画质下限,构图余量管动作空间,两个都得查。
先说可动区域。模型对首帧的尊重偏执到不讲道理:照片里脸清楚、手是三根模糊的肉条,视频里脸还在,手会继续烂下去,动作越大烂得越快。我现在出图后把手、脸、脚挨个放大看一遍,任何一处糊,这张图就不配当首帧——重出比补救便宜。
再说构图余量。动作会「出画」:首帧里模特头顶到画面上沿,视频里她一抬手,手指直接消失在画框外;脚贴着底边,走两步就切脚。我的经验值:模特高度占画面七成以内,四周留一成半到两成的空,特写另算。留白不是浪费,是给动作预租的场地。
| 首帧三要素 | 出图时要检查什么 | 没做到的后果 |
|---|---|---|
| 姿势幅度 | 姿势收到五成,留出发力空间 | 大开大合的姿势动不了,成片像会眨眼的照片 |
| 可动区域 | 手、脸、脚逐个放大检查,糊了就重出 | 糊的部位视频里更糊,动作越大崩得越快 |
| 构图余量 | 模特占画面七成以内,四周留空 | 抬手出画、迈步切脚,动作被画框硬生生切断 |
三层叠在一起才是完整的首帧:姿势有蓄力、部件全清楚、四周有地方动,缺一样,视频就缺一块。
为动而拍:出静态图时就想好这张要不要动
出静态图的时候就要想好这张要不要动:为视频准备的首帧,姿势只摆半张、四肢四周留空,而不是先出图再硬驱动。首帧意识要前置到出图那一步。
说个有点丢人的翻车。有次我拿一张特别满意的坐姿图驱动「起身」:图里模特陷在深色沙发里,重心全压进坐垫,一只手搭在扶手上,稳得像钉住了。我寻思模型总能让她站起来吧。结果视频里,模特像被一根看不见的线从头顶拽着——屁股先离开沙发两厘米,整个人垂直平移上去,膝盖中途还反折了一下,恐怖片都不带这么拍的。重跑了五次,一次比一次吓人。
问题不在提示词。那张图是「完全坐死」的:没有一点要起来的趋势,模型没有任何「顺势」可借。后来我重出了一张首帧——身体前倾三十度左右,一只手已经撑在坐垫上,重心移出沙发边缘——同一个「起身」提示词,一次过。两张图的差距,就是木偶和人的差距。
跑个题,我朋友拿这套思路去拍猫:猫毛糊成一团的图,出来就是一坨会动的棉花糖。首帧决定论不挑题材。拉回来:我现在出图都会多问一句「这张要不要动」,要动,就按姿势半张、四肢留空来出;不动,才允许自己出摆满姿势的漂亮图。为动而拍,是我这大半年最大的习惯变化。
收拢一下:首帧决定论不是玄学,是模型的运转方式——它不修正你的照片,它放大你的照片。姿势留一半,糊的部位不出图,四周留好空地,再提前到出图那一步,废片率从七成掉到两成不是我夸张,是记录里的数字。首帧多花十分钟,视频少熬一个通宵。
常见问题
首帧是不是越清晰越好?
清晰是底线,但不是全部。首帧查的是「可动」:糊的部位视频里会更糊,可过度磨皮的图也不行,皮肤在视频里会塑料感加重。清晰、有质感、部件完整,三者都要占。
首帧里模特占画面多大比较合适?
常规动作镜头,模特高度占画面七成以内,四周留一成半到两成的空。特写镜头可以占得更满,但动作幅度要相应收小,不然手指和下巴很容易出画。
已经有一张姿势很满的好图,怎么办?
别硬驱动。用局部重绘把姿势收到五成左右,或者把动作预期降下来——摆满的图配轻微动作(转头、发丝、裙摆微动)还能用,配大动作必翻车。
尾帧要不要一起管?
先把首帧管明白,再碰尾帧。首帧决定下限,尾帧控制走向,顺序反了就像地基没打先挑窗帘。等你能稳定出片了,首尾帧一起夹,可控性还会再上一截。