AI模特运镜与Ai女模特效词典:推拉摇移跟在AI视频里怎么用
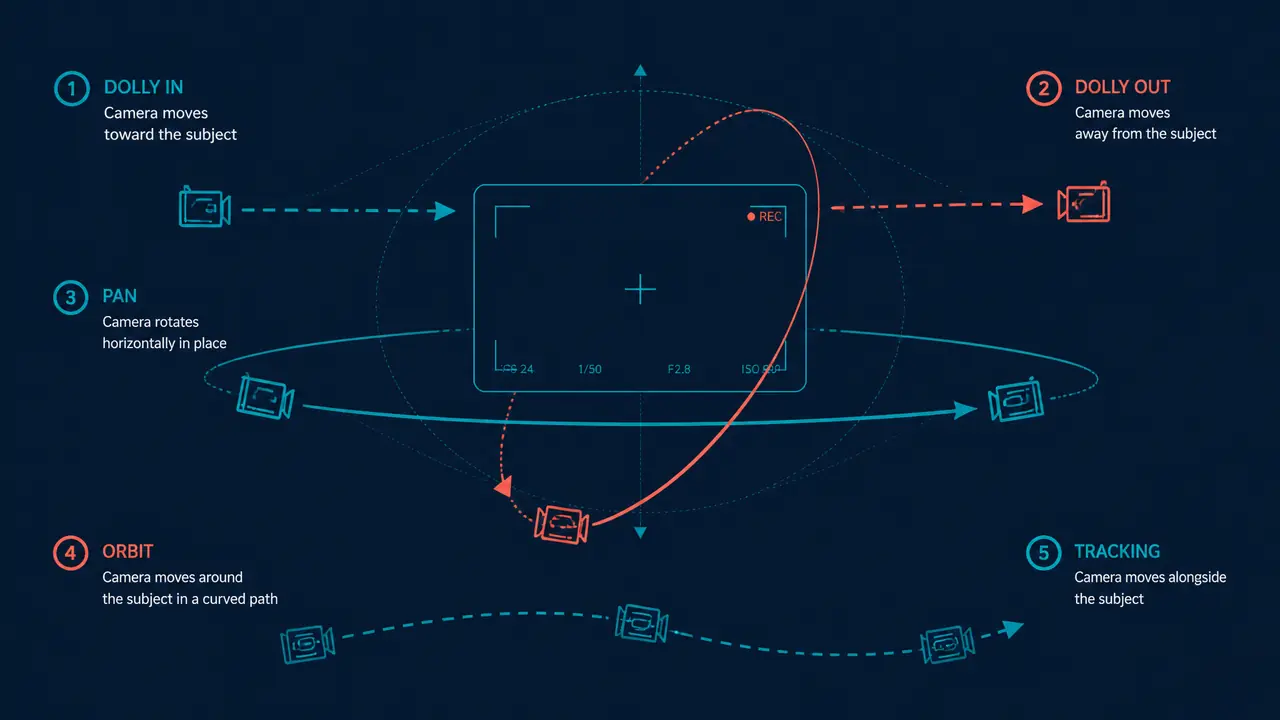
先交个底:AI视频里的运镜不靠手,靠提示词。推拉摇移跟五种运镜都能在图生视频里做出来,命门是运动幅度——大了衣服细节糊,小了像PPT。再记一条:一个镜头只放一个主运动,服装展示就用环绕、推近、定格三镜一组。
AI模特运镜这件事,我是转做AI视频之后重新学了一遍的。以前拍服装带货短视频,推拉摇移跟全在手上,稳定器往哪边推、脚步跟多快,肌肉记忆自己会做主。换了AI工具才发现,这五个字一样都摸不着,全得翻译成文字,让模型替你运镜。
把这两年踩的坑整理成一份词典:五种运镜在AI工具里的实现思路,运动幅度怎么控,运镜、特效、节奏三件套怎么搭,最后是服装展示视频里我验证过最顺的三套镜头组合。写给同样从实拍转过来的朋友,也写给一上手就没摸过稳定器的。
推拉摇移跟:五种运镜在AI视频里的实现思路
图生视频里的运镜全靠两样东西:文字提示词写运动方式,幅度参数控运动强弱。写清一个动作、配中低档幅度,是五种运镜的安全区。
原理先摆清楚。图生视频的起点是一张静态图,模型默认它就该静止,你不说运镜,它顶多给点呼吸感。提示词我惯用一个骨架:主体加动作加速度加幅度档位,比如「镜头围绕模特缓慢环绕,运动幅度中低」。前半句定运镜类型,后半句定力度,缺一半都容易跑。
幅度是我交学费最多的地方。有条女裙的片子,我把幅度杆拉到顶,想让环绕更带感:第一帧蕾丝纹理根根分明,环绕半圈回来全是色块,腰头的印花直接糊成一团。压到最低呢,出片跟PPT轮播没两样,观众手指一秒就划走了。现在我用0到10的幅度杆,习惯落在3到5;环绕这类旋转动作往低取,直线推拉可以放宽半档到一档。
五种运镜分头说。推和拉最稳,直线运动,模型理解得最好,「镜头缓缓推近模特,从全身到半身」这类提示词基本一遍过。摇是机位不动、镜头转向,AI里容易把背景横移拉成丝,转向角度一定写小。移和环绕是服装片的主力,立体感全靠它,但整圈环绕是高危动作,转过半程,背面经常被模型脑补坏。跟最难,要让模特走起来、镜头跟着走,步态稍不留神就鬼畜,腿部打结是常客。
| 运镜类型 | 画面效果 | AI实现要点 | 翻车风险 |
|---|---|---|---|
| 推(推进) | 视线聚焦,从全身收到半身或细节 | 写「缓慢推近」,幅度5左右 | 推太快五官变形,图案糊掉 |
| 拉(拉远) | 从细节回到全身,交代整体版型 | 写「镜头缓缓拉远,露出全身」 | 拉太远四肢崩,背景乱长东西 |
| 摇(摇镜头) | 机位固定,视线横向扫过 | 转向角度写小,配「缓慢」 | 背景横移拉丝,像信号故障 |
| 移(环绕) | 绕着模特转,展示立体剪裁 | 角度压到120度内,幅度取低档 | 转过半圈人崩,衣服穿模 |
| 跟(跟随) | 跟着模特走动,现场感强 | 走步提示词加「跟拍视角」 | 步态鬼畜,腿部打结 |
这张表是我拿二十多条废片换来的。印象最深的一次,给客户做风衣展示,环绕写成了「快速环绕」,片子转到侧面时衣服下摆直接穿进身体,整条报废。重做时只改了两个词——缓慢、低幅度,一遍过。AI运镜的翻车,十次有八次栽在力度上,不是栽在方向上。
运镜、特效、节奏:三件套怎么配合
一个镜头只安排一个主运动:运镜当主,特效当副,节奏负责把动静错开。三个同时发力,画面必糊。
先把三个词拆开。运镜是镜头层面的位移,推近、环绕都算;特效是画面里的小动作,发丝飘动、裙摆微动、光斑流动这类;节奏是镜头时长和切换点的安排。实拍的时候,老摄像师不会又推又摇又跟,一个镜头一个意图。AI视频一个道理,而且更较真——运动指令叠到三个以上,模型就开始牺牲细节,还你一片糊。
我现在的排法是错峰。一个5秒镜头:前两秒给主运动,推近或者环绕;中间一秒半收住,让面料细节喘口气;最后交还给轻特效,发丝飘一下收尾。切换点永远卡在运镜收住的静帧上,别在运动最快的时候切——那是当年剪广告片落下的习惯,到了AI视频里照样保命。
节奏上还有一条:不必每秒都动。观众的眼睛需要落点,全是运动等于没有运动。我刷到过一条同行做的长裙视频,8秒里镜头没停过,看完只记得晕。反过来,一个静止半秒的细节定格反而最容易被截屏。电商视频里,能被截走的那一帧才是转化。
服装展示视频最管用的三种镜头组合
全身环绕、半身推近、细节定格,三镜一组是服装展示片的骨架:看版型、看面料、看做工,各管一层。
第一镜,全身环绕,开场定全场。提示词写「镜头围绕模特缓慢环绕120度,运动幅度低」,3秒左右。为什么是120度不是整圈,前面说过,环绕过半背面容易被脑补坏。这一镜的任务是让买家看懂版型:衣长、肩线、腰身,一眼扫全。
第二镜,半身推近,讲面料。腰部以上,「镜头缓缓推近至上半身,幅度5」,3秒。推近这个动作本身就是注意力引导,观众视线会跟着镜头走,呢料的肌理、衬衫的领口,都是在这个过程里被看清的。
第三镜,细节定格,收做工。纽扣、走线、袖口的标识,提示词写「画面定格在袖口特写,仅有轻微的布料起伏」,2秒。AI里做定格有个取巧办法:首尾帧放同一张图,幅度压到1以内,模型就不敢乱动。这一镜是给决策用的,很多下单的人,看的就是走线齐不齐。
三镜串起来,环绕3秒加推近3秒加定格2秒,8秒一条。我给一个女装工作室按这个骨架连出十几条,废片率从对半砍到两成以内,后来他们自己照着写提示词也能出活。组合的价值就在这:不用每次重新发明镜头,省下来的力气花在调幅度上。
从扛稳定器到打字运镜,工具换了一整轮,镜头语言的底子没变:一个镜头一个意图,动静分主次,观众的眼睛永远需要一个落点。词典摆在这了,剩下的得靠你拿自己的图一条条试——AI运镜这东西,看十篇教程,不如亲手废三条片。
常见问题
提示词里一次写几个运镜动作合适?
一个。写「推近」就别同时写「环绕」,两个动作挤进一句话,模型多半给你糊成第三种运动。想换动作,另起一个镜头段。
运动幅度参数设多少,衣服细节不会糊?
我的经验是0到10的滑杆落在3到5,环绕类取低不取高。拿不准就先出2秒试验片,盯着衣服花纹边缘看,糊了就往下降一档。
环绕运镜转到一半人物就崩,怎么办?
把环绕角度压到120度以内,或者拆成两段各转半圈、剪到一起。360度整环对眼下的图生视频模型还是高危动作,能躲就躲。
特效加到什么程度算够?
一个镜头一处就够,发丝、裙摆、光斑挑一样。特效是给运镜托底的,抢了主运动的戏,整条片就散了。