ai创作模特视频怎么做?我把上新图变成走秀片
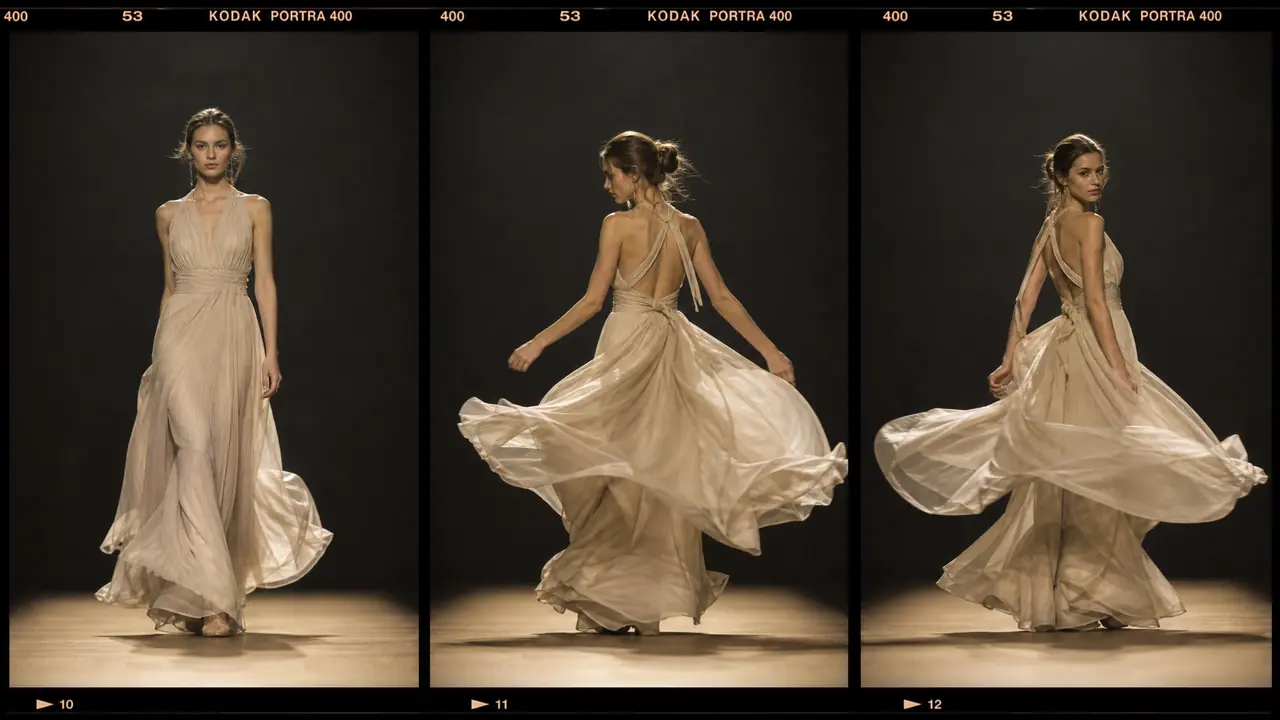
把话放这儿:AI模特视频成不成,七分看首帧图,三分才轮到视频模型。首帧是视频的地基,地基歪了神仙也扶不正。我给三家店做视频代运营的流水线和翻车账本全在这篇,五步抄走就能开工。
静图到视频,哪一环最要命
图生视频的第一帧就是生视频的"定妆照",人物结构、衣服细节、地面接触点全由它锁定,首帧有明显瑕疵,视频会把它放大成灾难。先伺候好图,再谈视频。
我做短视频代运营,主打服饰类客户。去年底开始把客户的上新图转成动态视频,头一个月交片率惨到想转行。复盘下来问题全不在视频模型身上:首帧图里模特的脚和地面接触含糊,视频里模特就一路"漂移",像在冰面滑行;首帧里裙摆有根线条含糊,五秒视频能把那根线抖出残影。视频模型是放大器,图里的一分含糊,片子里还你十分。
我的首帧标准后来定成三条:脚和地面有清晰的接触阴影,手部要么入镜且结构完整要么干脆出画,衣服边缘线条干脆没有半透明杂质。达到这三条的图,视频一次过片率能到六成;不达标的图,先回去修图,别硬跑,硬跑就是烧钱听响。
有个细节很多人栽过:首帧分辨率。传一张六百多像素的图去生视频,出来糊成一锅粥。我统一把首帧放到横图一千二百八以上再进视频环节,这一步不花几个点数,成片清晰度天差地别。
五步流水线:上新图到走秀片
流程五步:挑首帧、写运镜词、先出三秒测试、择优续跑加长、按投放平台裁尺寸配乐。全程一条五秒成片的材料成本三到八块,比一次实拍便宜两个量级。
第一步挑首帧,标准就是上面三条。第二步写运镜词,我的常用组合是"缓慢推近加轻微环绕",模特原地走秀感就出来了;千万别贪心写复杂运镜,镜头一绕大圈,模特的脸就给你糊掉。第三步,先跑三秒测试版看动态稳不稳,稳了再续到五秒十秒,不稳换首帧,别在烂底子上续命。
第四步续跑加长,这里有个省点数的诀窍:第二段的末帧接着当第三段的首帧,一段一段接力,比整段重跑便宜三成。第五步裁尺寸,主图视频竖版九比十六,详情页横版十六比九,一次生成两边发,别偷懒只出一版。
产能账摆一下:一条五秒成片,测试加成片摊下来三到八块,一个晚上我能出二十条。客户实拍一条同类视频,场地模特灯光加后期,八百块起步还要排队。三家客户的月度视频产量从四条涨到四十条,账号更新频率直接换了个活法。
各家视频模型的差异和选择,这篇AI视频工具横评里对比得细,我按客户预算在两家之间切换,思路和它写的一致。
翻车实录:腿、裙摆和穿模的故事
视频环节三大翻法:走路腿打结、裙摆和腿穿模、手部进画面后变形。都有对应的省钱解法,覆盖提示词、姿势选择和构图取舍。
腿打结是我交过最贵的学费。一批走姿视频,模特迈步的瞬间两腿交叠,模型分不清前后,续出来的步子像拧麻绳,二十条废了十四条。解法是把首帧换成"走路中段"的姿势——两腿自然分开的那一帧,模型接续起来最稳;正准备迈步的静止帧最容易出事。
裙摆穿模多发生在长裙。裙摆和腿的边界一含糊,腿就从裙子里"长"出来,或者裙摆直接吞了膝盖。我现在长裙视频一律让模特走"提裙摆"的姿势,手动把边界划清楚,穿模率从四成掉到一成。手部变形用老三样解决:手里给个道具,或者干脆半身构图,视频里手比图里更会作妖。
翻车归翻车,这活儿的性价比依然碾压实拍。就像从手洗衣服换到洗衣机,偶尔甩不匀,没人真想回去搓板。我在意的从来不是它完美,是它把"动态展示"这件奢侈品变成了日用品。
回头串一遍这条流水线:首帧三标准、运镜词克制、三秒先试水、末帧接力跑、一鱼两吃裁双版。AI创作模特视频这件事,门槛不在技术在纪律——每一步的检查动作做了,出片就是水到渠成。我那三家客户的主图视频位现在常年在更新,回头客说刷到店铺像刷到频道。下个月赶上秋冬上新,我打算试一版雪地走秀的场景词,成了回来写续篇,砸了也回来写,账我都记着呢。
常见问题
生成一条视频要等多久?
五秒片段一般在两到五分钟之间出结果,高峰期慢些。我都是批量排队跑,晚饭前把单子挂上,收拾完厨房回来挑片,时间刚好。
模特视频会不会被平台限流?
目前主流内容平台对AI生成内容的要求是主动标注,标注了不影响分发。我们代运营的视频统一打了"AI生成"标识,跑了半年多,数据没有异常。
视频里的衣服颜色和商品图对不上怎么办?
首帧图用商品实拍校准过的版本,视频只负责让首帧动起来,颜色跟着首帧走。真出现偏色,回炉改首帧比改视频省事十倍,这个顺序别搞反。
小店铺一个月该产多少条视频?
按上新节奏倒推,每款一条五秒主图视频加一条氛围片就够。我见过贪多日更十条的店,视频质量参差反而拉低店铺调性,宁缺毋滥在这行是真的。
延伸阅读
想对比各家视频模型的长短板,可以看这篇Sora与可灵视频对比,和工具横评那篇互补着看。