ai绘画环境怎么搭?三档预算从云端到本地的清单与顺序
一句话版本:ai绘画环境按出图频率分三档——偶尔画用云端,每周画上二手中配,天天出的才值得高配本地。我是成都做UI设计的,2026年3月给自己配了台出图机,前后的账算给你看,照着搭能少花冤枉钱。
ai绘画环境这个词,多数人搜的时候心里想的是「我这电脑到底行不行」。答案取决于两件事:你打算多久出一张图,以及你要不要可控的工作流。一个月画三张纪念图的,和每天要出十张找灵感的,根本不该买一样的配置。
我搭环境之前在云端订阅了半年。订阅费每月几十块,出图等待一到两分钟,对当时的频率完全够用。转本地的契机是工作流复杂了——多图层控制、局部重绘、批量出变体,网页端做不了。所以我给别人的第一句建议永远是:别一上来就买卡,先确认你的需求真的长到云端装不下了。
三档环境怎么选:频率决定预算
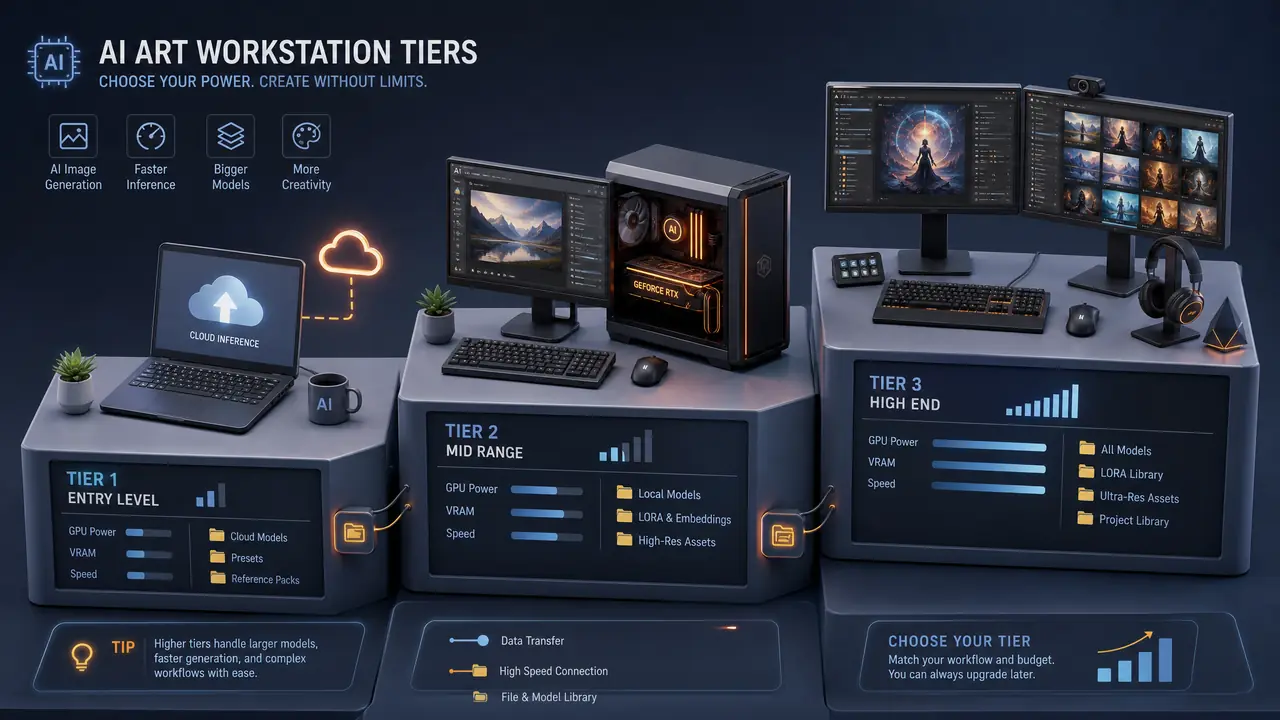
环境分三档:云端订阅零门槛、二手中配主机够日常、高配机扛批量工作流。按出图频率对号入座,别为用不上的性能买单。
三档的差异我列成表:
| 档位 | 投入 | 适合人群 | 出图体验 |
|---|---|---|---|
| 云端订阅 | 每月几十元 | 偶尔画、纯尝鲜 | 排队1-2分钟,无需懂参数 |
| 二手中配 | 主机两千多 | 每周出图、做头像表情包 | SDXL单张30秒左右 |
| 高配本地 | 五六千起步 | 天天出图、接单、跑复杂工作流 | 批量出图,工作流全放开 |
我对中配那档最有感情,因为它性价比最高:一张二手的8G显存卡(我2026年3月入的,花了一千二),配个二手主板内存,两千五全下来。大多数人的AI绘画需求,这档就是终点,真用不到更好的。高配档只在两件事上有不可替代性:16G以上显存跑大模型,和多任务批量不排队。你要是靠这个吃饭,再上;不靠,省下的钱买排骨不香吗。
本地搭机的顺序:硬件、软件、模型各就各位
搭环境按顺序来:先查显卡显存,再装Python与ComfyUI,最后下模型放对目录。顺序错了处处报错,对了半天就能跑通第一张图。
硬件只强调三处:显存8G起步、硬盘留足100G(模型比你想的大得多)、电源别省。第三条我有切肤之痛——配机时电源按普通办公预留的,后来跑图满载直接黑屏重启,换电源折腾了一晚。买二手卡记得现场跑个压力测试,淘宝店不退不换的比例不低。
软件顺序是:先装Python(勾选加入环境变量),再拉ComfyUI整包,启动器会帮你装依赖。第一张图用自带的默认模型出,确认整条链路通了再去下新模型。模型放models/checkpoints目录,一个模型动辄7G,下之前看清文件体积,我当时网络抽风下到一半的残包放进去,报错了半小时才反应过来。
驱动这层单独说。显卡驱动别开自动更新——2026年4月有一次自动更新后,我的出图速度掉了两成,回滚到旧版本才恢复。CUDA版本跟着ComfyUI启动器的提示走,自己别瞎追新。这套东西装完你就明白了:所谓环境,一半是配置,一半是别乱动。
日常维护与断网预案:让环境活得久
日常维护三件事:模型分目录归档、每月清一次出图缓存、留一套断网也能跑的底模。环境是养出来的,不是装完就完。
出图缓存是隐形空间杀手。我的outputs目录三个月堆了90G,全是当时顺手没删的废图,现在固定每月最后一个周日清一次,留精删糙。模型同理,下载前想清楚用途,三个月没碰的移进冷备盘——硬盘空着,出图才不憋屈。
断网预案很实在:底模和常用微调都在本地硬盘上,断网照样出图,这也是本地环境相对云端的核心底气。2026年6月我家宽带故障三天,我照常给朋友出了两套头像,云端订阅派就干瞪眼了。顺便提一句,想搞懂模型文件和源码到底怎么归置的,这篇ai绘画源指什么:模型权重、源码、素材源分开说把概念捋得很清。
那台机器如今是我下班后最常坐的位置,周六早上出十张图挑一张发朋友圈,成了固定节目。回头看,搭环境这事最大的坑不是配置不够,是配置超过需求——朋友的教训是五千配的机器现在吃灰,我的庆幸是两千五的卡刚好够用。你先诚实地估一估自己一周出几张图,答案自然就出来了。
常见问题
纯小白用云端订阅丢人吗?
一点都不丢人。云端出图快、不用维护,频率低的话成本远低于买卡。工具是为产出服务的,你的图好看才是重点,跑在哪儿没人关心。
AMD显卡能搭本地环境吗?
能,但折腾。主流工具链对AMD的兼容在2026年仍差半拍,装环境的教程也少。预算够就上N卡省心,手上已有A卡可以先试DirectML方案,跑通了再深玩。
笔记本电脑能当出图机吗?
看配置:显存6G以上的游戏本可以跑SDXL,注意散热——长时间批量出图会撞温度墙降频。出门用够呛,当备用机合格,当主力机不如台式。
模型下多了会互相冲突吗?
不会冲突,只占硬盘。不同模型随时切换加载,放心收集。真正要注意的是别下来源不明的整合包,里头可能夹带脚本,只用官方底模和知名作者的发布页下载。